


引言
其中
在传统算法领域,为克服反演问题的病态性,研究者们普遍采用正则化的方法.由Tikhonov提出[7]的L2正则化方法是较早得到使用和发展的一种方法,其通过在目标函数中加入L2范数惩罚项来稳定函数解.Butler等人[8]在此基础上,于求解函数中引入非负约束,提出了BRD算法,优化了反演准确性和稳定性,在一维反演中应用广泛.Day等人[9]则提出了L-curve及广义交叉验证等方法,用于优化L2正则化参数的选择,提高了反演的效率和准确性.近年来,在反演问题的求解过程中,基于L1正则化的快速阈值迭代方法也逐渐被开发采用,该方法具有优秀的窄峰分辨能力和计算效率[10],并在后续发展中由Berman等人[11]应用于NMR反演中,在数据SNR>500时能够进行稳定求解.随着正则化方法的进一步发展.Zou等人[12]提出了一种L1/L2混合范数正则化方法,Luo等人[13]则在此基础上,在目标函数中引入低秩约束,提高了算法对SNR<100的1D数据反演结果的分辨率和定量识别能力.虽然上述方法在不同程度上改善了反演稳定性,但仍存在局限性.首先,正则化反演高度依赖正则化参数,因此在实际应用中通常需要进行多次测试与调参,以达到最佳反演效果,这不仅耗时耗力,也会降低算法在复杂场景下的实用性.其次,正则化反演求解往往涉及迭代优化过程,计算量大且过程复杂,在实时处理或需要大规模数据反演的场景中容易受到计算效率瓶颈的限制.
随着深度学习技术的快速发展,研究者们开始尝试将深度学习运用到NMR反演问题的求解中.Parasram等人[14]使用简单的全连接神经网络,对深度学习技术在NMR反演问题中的应用做出初步尝试.Luo等人[15]提出一种注意力机制与卷积特征提取结构相结合的ATT-CNN网络,能够更好地适应弛豫信号衰减特征,并得到更准确的横向弛豫时间(T2)反演结果谱.Chen等人[16]则将Transformer结构融入到反演网络中,实现了对SNR>40的时域信号的快速稳定反演.这些研究表明,深度学习技术在提升反演准确性和稳定性方面具有突出的潜力.然而,现有的深度学习模型在面对具有多组分的低信噪比数据时,其反演结果仍面临稳定性不足、精度有限等问题,亟待构建更具鲁棒性与表达能力的深度学习模型,以提升低信噪比数据的反演质量.
针对上述问题,本文提出了一种适用于低信噪比LF-NMR T2谱反演的深度学习方法——结合U-Net降噪和多尺度交叉注意力的反演网络(U-Net Denoising and Multi-scale Cross Attention Inversion Network,UDMCA).在该网络中,根据NMR时域信号的物理结构特征,创新性地融入了多尺度交叉注意力机制,在充分提取信号细节及局部衰减特征的同时,保持对整体结构及噪声水平信息的有效表征,以提升对多组分信号的反演能力及抗噪鲁棒性.同时采用级联式设计,在反演模块前端集成U-Net去噪模块,并结合联合损失函数引导训练,以进一步提升网络的抗噪能力.在通过标签T2谱正演出NMR时域信号以构建训练数据集并完成模型训练后,本文分别利用模拟数据与溶液模型数据对UDMCA网络进行性能验证,并与传统BRD方法及深度学习方法ATT-CNN进行了系统对比.最后,将本方法应用于岩心NMR数据处理进行适用性验证.
1 基于深度学习的一维反演网络原理
1.1 T2弛豫测量及反演
其中,
其中,
此时,一维反演问题已经转化为一个经典的已知S和K,求解f的逆拉普拉斯变换问题.在求解该逆问题的过程中,常规算法通常采用正则化的方法对(4)式进行处理,使其转化为具有非负约束的Tikhonov问题[7],如(5)式所示:
然而在实际应用过程中,当时域信号中的噪声干扰
1.2 网络结构
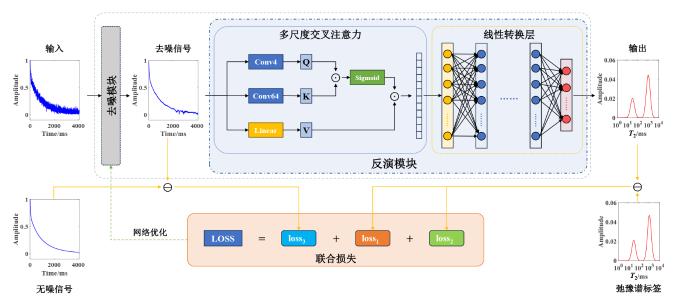
本文提出一种级联化设计的网络结构UDMCA,由去噪模块(Denoise Module)和反演模块(Inversion Module)两部分组成.该网络首先对输入网络的原始NMR时域信号进行去噪处理,得到去噪信号后,再通过反演模块进行对应结果弛豫谱的转换输出,具体的网络结构如图1所示.
图1
1.2.1 去噪模块
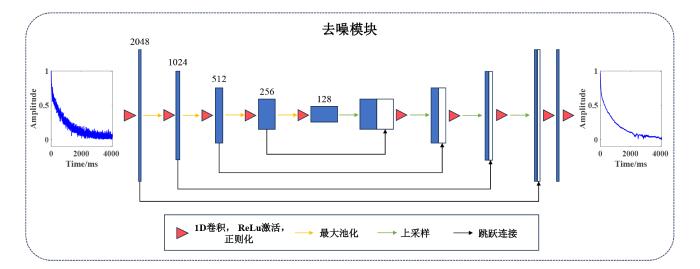
在网络结构中,去噪模块采用了U-Net编码器-解码器架构[19,20],其结构示意图如图2所示.该模块的编码器部分由一维卷积层、正则化层以及最大池化层组成,用于对输入的带噪原始时域信号进行多层次特征提取.随着网络层数的加深,特征通道逐步扩展,信号长度由2 048依次减半至1 024、512、256和128,从而实现对时序信息的层次化压缩与特征提取.在解码器部分,网络通过一维卷积层、正则化层以及上采样操作对编码后的深层特征进行逐步重建.同时,利用跳跃连接(Skip Connection)将编码器相应层的特征与解码器对应层进行特征融合,以有效缓解特征传递过程中的信息丢失问题.为进一步增强网络的非线性表达能力,编码器与解码器的各卷积层均采用ReLU作为激活函数,以适应T2时域信号的非负数值特征.经过解码阶段后,网络最终将深层特征映射还原为长度为2 048的一维信号,即去噪后的时域信号,从而在保留信号主要时序结构的同时,有效抑制噪声干扰.
图2
1.2.2 反演模块
反演模块是实现NMR时域信号转换为T2弛豫谱的核心网络结构.为实现反演转换的准确性和稳定性,在该模块中包含了多尺度交叉注意力机制和线性转换层两部分.
多尺度交叉注意力机制(Multi-scale Cross Attention)是本文为实现对NMR时域信号进行复杂多尺度特征融合提取所提出的一种特征提取机制,其原理如图3所示.作为网络的核心特征提取模块,其基本原理为:首先,将去噪后的信号分别输入卷积核大小不同(分别为4和64)但步长相同的卷积层,其中卷积核大小的选择取决于信号长度2 048,大小为4的卷积核(4 Convolution Kernel,Conv4)适用于细节衰减特征提取,64大小的卷积核(64 Convolution Kernel,Conv64)则适用于局部衰减特征提取,由此可分别提取到细节特征矩阵Q与局部特征矩阵K.随后通过矩阵点乘运算并结合Sigmoid激活函数,得到多尺度局部特征权重矩阵Weight,最后再通过点乘,将多尺度局部特征信息嵌入到由线性层(Linear)处理得到的全局特征矩阵V中,形成局部特征和全局特征的交叉注意,最终得到融合了多尺度信息的全局特征向量,即多尺度融合特征.
图3
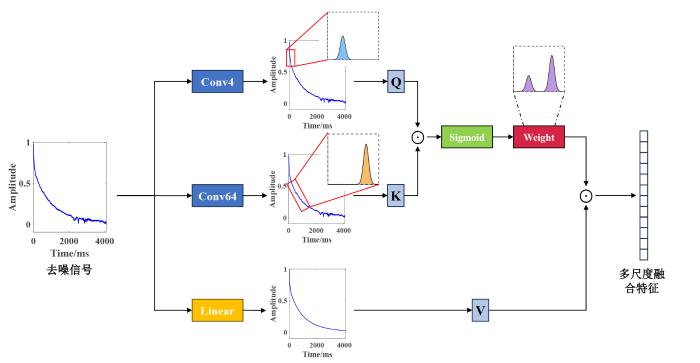
本文所提出的多尺度交叉注意力机制,对NMR时域信号中蕴含的复杂物理结构特征进行了针对性提取.其中关注细节特征的小尺度卷积核用于捕获在信号前段快速衰减的短弛豫组分信息,而大尺度卷积核所关注的局部特征,则对应于衰减速度更慢的长弛豫组分信息.同时,由线性层提取的全局特征向量则更关注信号整体能量分布及噪声水平,用于补充卷积操作难以直接获得的宏观特征,提高网络的鲁棒性.通过多尺度交叉注意力机制,网络在特征提取过程中不仅保留了去噪信号的结构形状特征,还有效强化了以全局信息为主导的多尺度综合表征,实现了对一定信噪比条件下NMR时域信号的多尺度特征融合提取,提高了反演的准确性和稳定性.
线性转换层则由多层全连接层组成,其主要作用是对多尺度交叉注意力机制输出的融合特征向量进行非线性映射,以生成具有相应输出点数的弛豫谱.在本文所提出的网络结构中,该模块包含五层维度为2 048的线性层及一层维度为128的线性层.前五层维度与输入的多尺度融合特征维度保持一致,通过逐级的线性变换与非线性激活实现对高维融合特征的深层次抽象与重构,而最后一层线性层则将特征映射压缩至长度为128的一维结果,对应于最终具有128布点数的弛豫谱输出.通过这种逐层映射方式,网络能够在保持特征表达能力的同时,有效建立输入特征与目标弛豫谱之间的非线性映射关系.
1.2.3 损失函数
为确保所构建的UDMCA网络能够得到充分训练,本文采用有监督学习模式进行模型参数优化,并设计了一种联合损失函数(Joint Loss Function),以协同约束网络中不同功能模块的学习目标.联合损失函数包含三个损失项,分别为对照损失项、结构损失项与去噪损失项.
首先,对照损失项(loss1)用于衡量网络输出的反演结果与标签弛豫谱之间的差异,通过计算二者间的均方误差(Mean Square Error,MSE)得到,其计算公式如(6)式所示:
其中,
其次,结构损失项(loss2)由网络输出反演结果与标签弛豫谱计算交叉熵(Cross-Entropy,CE)损失得到,这是因为网络输出的结果及对应标签均已经过归一化处理,故可直接使用交叉熵进行计算.其具体计算公式如(7)式所示:
结构损失项同样作用于反演模块,旨在弥补对照损失项在依照标签约束输出反演结果时对全局结构特征关注不足的缺陷.通过结构层面的约束,结构损失项能够有效提升反演结果的峰形拟合能力,使其在形态上更加接近真实谱分布.
最后,去噪损失项(loss3)用于约束网络中的去噪模块,通过计算去噪模块输出信号与无噪参考信号之间的均方误差获得,其具体公式如(8)式所示:
其中,
2 实验部分
2.1 数据集构建
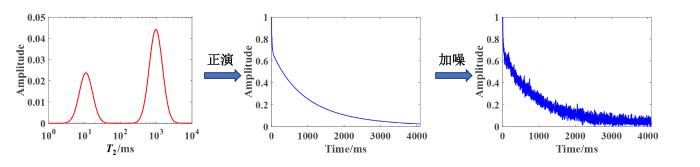
为使所搭建的UDMCA深度学习网络得到充分训练,需构建数量充足且合理的数据集.由于高信噪比的实际测量NMR时域数据采集成本高且耗时长,难以满足大规模数据训练的需求.因此,本文基于NMR物理机制采用正演建模,通过数值模拟构建网络训练所需的仿真数据集.正演数值模拟流程如图4所示,主要分为三个步骤:(1)确定弛豫时间组分数量及各组分峰对应的T2值,并生成相应的T2弛豫时间谱F(T2);(2)利用反演核将T2弛豫时间谱正演为无噪NMR时域信号Y(N);(3)对NMR时域信号进行加噪处理,以模拟输入数据S(N).
图4
首先确定模拟数据中组分的数量及对应的峰值,用i表示相应的组分,则
其中
根据生成的弛豫时间谱,依照(4)式进行正演即可得到无噪NMR时域信号,过程如(10)式,其中N表示信号数据点数即回波个数.
SNR的定义如(11)式所示,为时域信号中最大点的幅值
根据该定义,可计算得到所需施加噪声的标准差以进行输入信号的生成.由于实际采集的时域信号具有实部和虚部两部分信息,在进行反演时通常经过abs取模处理,此时实采时域信号中的噪声特征符合莱斯分布.为生成贴合实采的有噪输入信号,本文对无噪信号采用莱斯加噪的方式,具体形式如(12)式所示,其中,
最后本文数据集的生成参数设置为回波个数为2 048,回波间隔为2 ms,T2的布点范围为1 ms~10 s间对数布点,布点数为128.数据总量共200 000对,采用比例分布均匀的单组分数据、双组分及三组分数据混合随机生成.数据加噪范围为10~50,选择该范围是因为本文的主要研究对象是岩心或岩屑样品,其孔隙度一般在5%~10%,且体积不大,在低场强环境下(
2.2 模型训练
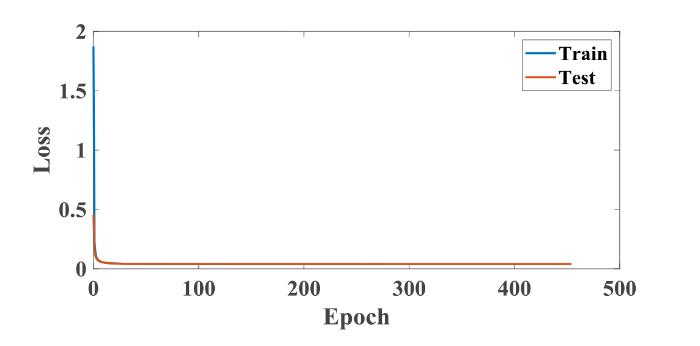
在模型训练阶段,本文采用了2.1节所述的正演模拟方法生成共200 000对样本数据,并按照4 : 1的比例划分为训练集与测试集.在实际训练过程中,各项参数设置如下:批处理大小(Batch Size)设为200,最大训练轮次为600;网络参数优化采用Adam优化器,初始学习率设为1×10⁻⁵.当连续20轮训练过程中损失函数值无明显下降时,学习率按原值的0.1倍进行衰减,最小学习率限定为1×10⁻⁹.当训练过程中连续50轮损失函数值未出现明显下降,或训练轮次达到600轮时,认为模型已达到收敛状态.此时保存最近一次损失函数下降时对应的网络参数,并将其作为最终训练完成的模型.实际训练过程中训练损失(Train)和测试损失(Test)下降趋势如图5所示.
图5
2.3 实验设计
为了系统验证提出UDMCA网络的综合性能,本文设计了四组实验,即统计模拟实验、模拟组分实验、溶液模型实验以及岩心分析实验进行性能测试.在深度学习技术对比方面,选取同样用于一维T2弛豫时间反演的ATT-CNN[15]网络作为深度学习基准方法.为了有更好的对比性,ATT-CNN网络使用的训练数据集与本文网络训练数据集保持一致.同时,本文所有神经网络框架均基于Python3.7和Tensorflow2.3.0进行搭建,并使用2.90 GHz Intel Core i7-10700和NVIDIA GeForce RTX 2080Ti的服务器进行训练.对于单个模拟数据反演效果的对比,则选择使用广泛的基于非负约束L2正则化的BRD[8]反演方法作为传统方法基准,具体使用MATLAB平台代码来实施反演.
在统计模拟实验中,本文采用正演模拟的方式分别生成了SNR=10, 20, 30, 40, 50的随机三组分模拟数据各5 000组(输入信号及对应的标签弛豫谱).随后使用UDMCA网络与ATT-CNN网络分别对模拟数据进行反演测试,将所得结果与标签弛豫谱进行对比.本文将采用均方误差(MSE)和决定系数(R2)来作为反演效果的评价指标,其中MSE的计算方式如(13)式所示,R2的计算方式如(14)式所示.
其中,n为数据集对数,
在模拟组分实验中,本文基于正演建模生成了不同信噪比的NMR时域数据,作为模拟测试数据,以系统评估UDMCA网络在不同噪声环境下的鲁棒性.具体而言,在SNR为10、20和40的条件下,分别构建了单组分、双组分及三组分数据,共计九组模拟实验数据.其中单组分数据T2峰值设置为72.16 ms,双组分数据T2峰值设置为10.95/982.03 ms,三组分数据T2峰值设置为10.95/72.16/982.03 ms.对生成的九组数据分别使用UDMCA算法和BRD算法进行反演,并将所得结果与模拟标签进行对比评价.
在溶液模型实验中,本文选用五水合硫酸铜固体(CuSO4•5H2O,国药集团化学试剂有限公司,分析纯)溶解于超纯水中,制备出32 mmol/L和2 mmol/L两种浓度的CuSO4溶液.将这两种浓度的溶液按1 : 1的体积比分别装入两支样品管,再将两支样品管进行并排固定,构建了一个双组分溶液模型,其中32 mmol/L的CuSO4溶液先验T2峰值为16 ms,2mmol/L的CuSO4溶液先验T2峰值为232 ms.信号采集使用中国科学院精密测量科学与技术创新研究院自主研制的6 MHz核磁共振仪器,采集参数中单次扫描等待时间设定为 1 s,回波数为2 048,回波间隔为2 ms,累加次数为16次,采集得到的NMR时域信号SNR为25.随后,分别利用UDMCA算法,ATT-CNN算法以及BRD算法对所得实验数据进行反演测试,并对所得结果进行定量对比与综合评价.
在岩心实验中,本文选取了三种不同的岩心样本,其中岩心1为红砂岩,岩心2为细砂岩,岩心3为人造砂岩.三种岩心均使用纯水真空浸泡24小时后进行测量,信号采集使用中国科学院精密测量科学与技术创新研究院自主研制的6 MHz核磁共振仪器完成,其中岩心1和岩心2的采集参数设置为回波间隔0.2 ms,回波数2 048,单次扫描等待时间1 s;岩心3的采集参数设置为回波间隔2 ms,回波数2 048,单次扫描等待时间1 s.将累加次数(NS)为256的高信噪比数据在BRD算法下的反演结果视为参考标签,并分别比较BRD算法与UDMCA算法对较少累加次数的低信噪比数据的反演性能.
3 结果与讨论
3.1 统计模拟实验
图6展示了对UDMCA网络和ATT-CNN网络在不同信噪比(SNR)条件下进行性能测试后,其对应评价指标的统计结果.表1则记录了具体的计算指标数值.通过图6及表1可以观察到,两种模型的评价指标中,均方误差(MSE)均随SNR的提高而减小,决定系数(R2)均随SNR的提高而更接近于1,说明两种模型的反演精度均随SNR提高而提升.进一步对比可见,在MSE指标上,对于设定的SNR条件,除SNR=30时,UDMCA网络的指标略高于ATT-CNN外,本文所提出的UDMCA网络的MSE均低于ATT-CNN网络,这种优势在SNR较低时更为明显,表明了其对于低信噪比数据的良好鲁棒性,以及在反演准确性方面具有更优表现.同时,UDMCA网络的R2在全信噪比设置条件下均更接近于1,相较于ATT-CNN网络表现出更高的拟合准确性.上述结果从定量角度验证了本文提出的UDMCA网络在反演精度和稳健性方面均优于对比网络.
图6
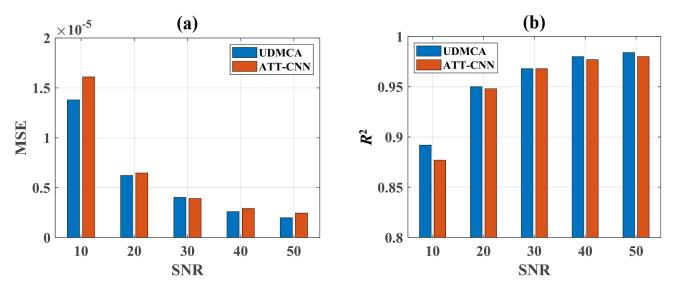
图6
不同信噪比条件下UDMCA和ATT-CNN反演性能对比. (a)均方误差;(b)决定系数
Fig. 6
Comparison of inversion performance between UDMCA and ATT-CNN under different SNR conditions. (a) MSE; (b) R2
表1 不同信噪比条件下UDMCA和ATT-CNN反演结果评价指标对比
Table 1
| SNR | MSE | R2 | ||
|---|---|---|---|---|
| UDMCA | ATT-CNN | UDMCA | ATT-CNN | |
| 10 | 0.00001384 | 0.00001610 | 0.892 | 0.877 |
| 20 | 0.00000622 | 0.00000647 | 0.950 | 0.948 |
| 30 | 0.00000402 | 0.00000392 | 0.968 | 0.968 |
| 40 | 0.00000260 | 0.00000292 | 0.980 | 0.977 |
| 50 | 0.00000199 | 0.00000246 | 0.984 | 0.980 |
3.2 模拟组分实验
UDMCA算法及BRD算法分别对九组模拟数据的反演结果与实际标签的对比如图7~9所示.根据结果可以看出,当模拟数据仅包含单组分时,无论采用UDMCA算法还是BRD算法,其反演所得弛豫谱均与真实标签具有较好的一致性.随着SNR的提高,两种算法的反演精度均有所提升.然而,从峰形细节的拟合程度来看,UDMCA算法的反演结果在谱峰位置及形状上均更接近真实标签,表现出更高的精度与稳定性.当组分数量增加至双组分时,可以明显观察到算法间的性能差异.虽然在较高SNR条件下,BRD算法仍能获得与真实标签较为一致的反演结果,但在低SNR情况下,其结果与真实弛豫谱之间已出现明显偏差,甚至出现峰位偏移与幅值失真等现象.相比之下,UDMCA算法在所有信噪比条件下均能准确分辨双组分峰,且峰位与幅值均与真实标签高度一致,表现出更强的鲁棒性.而当组分数量进一步增加至三组分后,由对比结果图可以看出,在全部SNR条件下,BRD算法所得反演结果均不准确,甚至出现“连峰”现象.而UDMCA算法虽然在SNR=10的三组分数据的反演结果上存在着可观察到的差异,但是依然能够较为准确地识别并定位三个组分峰.同时随着信噪比的改善,反演结果进一步得到改善,在高SNR条件下与真实弛豫谱几乎一致.
图7
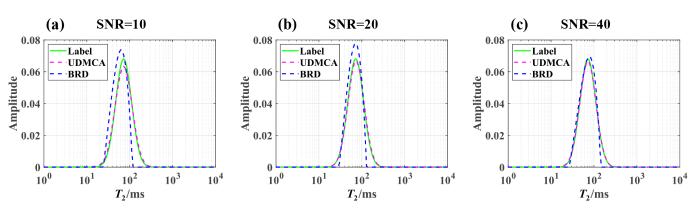
图7
不同信噪比条件下UDMCA和BRD对单组分模拟数据反演结果谱与标签弛豫谱对比图. (a) SNR=10;(b) SNR=20;(c) SNR=40
Fig. 7
Comparison of UDMCA and BRD inversion spectra with Label relaxation spectra for single-component simulated data under different SNR conditions. (a) SNR=10; (b) SNR=20; (c) SNR=40
图8
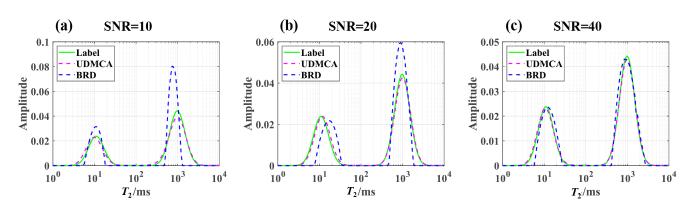
图8
不同信噪比条件下UDMCA和BRD对双组分模拟数据反演结果谱与标签弛豫谱对比图. (a) SNR=10;(b) SNR=20;(c) SNR=40
Fig. 8
Comparison of UDMCA and BRD inversion spectra with Label relaxation spectra for dual-component simulated data under different SNR conditions. (a) SNR=10; (b) SNR=20; (c) SNR=40
图9
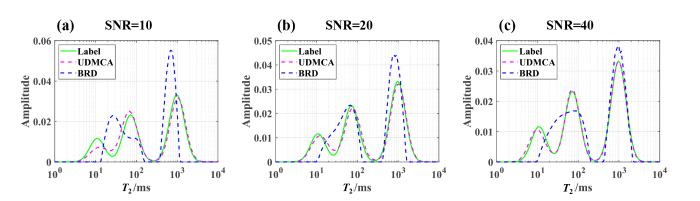
图9
不同信噪比条件下UDMCA和BRD对三组分模拟数据反演结果谱与标签弛豫谱对比图. (a) SNR=10;(b) SNR=20;(c) SNR=40
Fig. 9
Comparison of UDMCA and BRD inversion spectra with Label relaxation spectra for three-component simulated data under different SNR conditions. (a) SNR=10; (b) SNR=20; (c) SNR=40
综上所述,UDMCA算法在低信噪比及多组分条件下表现出优于传统BRD算法的反演精度与稳定性;即便在较高信噪比或少组分情况下,其反演结果仍具有更高的拟合精度和可靠性,充分验证了该算法的有效性与稳定性.
3.3 溶液模型实验
图10展示了三种算法在实际实验条件下对模型溶液信号(SNR=25)反演结果的对比,各算法对应的定量评价指标计算结果则列于表2中.根据图10所示结果及表2所记录数据可以看出,UDMCA算法在反演过程中所得到的结果,虽然在定量积分比上与传统算法相当,但在谱峰位置的预测上更接近实验设置的先验条件,表明其反演结果具有更高的准确性.同时UDMCA反演结果的峰形更加平滑,更有利于定量结果的观察与分析.相比之下,ATT-CNN算法所得反演结果,无论是在谱峰位置预测还是定量积分比上均不如UDMCA准确,且该结果的峰形虽然在整体上保持了一定的一致性,但在平滑性方面仍存在不足.综上所述,UDMCA算法在溶液模型实验中取得了最佳反演效果,进一步验证了其优越的反演准确性和定量能力.
图10
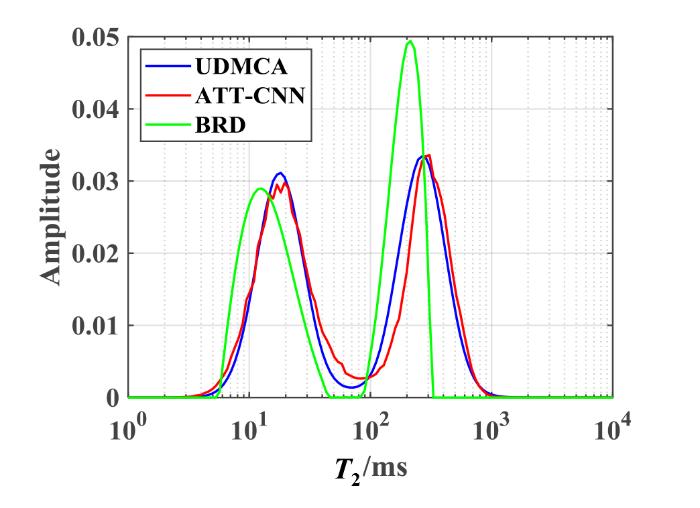
图10
UDMCA、ATT-CNN及BRD对溶液模型反演结果谱对比图
Fig. 10
Comparison of inversion spectra obtained by UDMCA, ATT-CNN and BRD for solution model data
表2 溶液模型实验反演结果评价指标记录
Table 2
| 模型 | 峰位置/ms | 积分比 |
|---|---|---|
| UDMCA | 18.19/266.2 | 0.95:1 |
| ATT-CNN | 19.56/286.2 | 1:0.88 |
| BRD | 12.66/214.1 | 0.95:1 |
3.4 NMR岩心实验
图11展示了本实验所用三种岩心实物,图12则展示了UDMCA算法与BRD算法对于三种岩心在不同信噪比条件下反演结果的横向对比,根据对比结果图可以看出,在红砂岩分析实验中,UDMCA算法在采用累加次数NS=16(SNR=56,采集时间22.5 s)的数据时,其反演所得T2谱在谱峰位置与峰强度方面均与BRD算法基于累加次数NS=256(SNR=189,采集时间361 s)的高信噪比数据所得的标签结果基本一致,而BRD算法在相同低累加次数数据下的反演结果则出现明显的峰位偏移.同样地,在细砂岩分析实验中,对于累加次数NS=8(SNR=28,采集时间11 s)的数据,UDMCA算法所得结果更加贴近于BRD算法在累加次数NS=256(SNR=159,采集时间361 s)的数据上所取得的参考结果;而BRD算法在该数据下所得结果不仅在长弛豫组分上出现了峰位偏移,更在中短弛豫组分上出现了明显偏差.在人造砂岩的分析实验中,对于NS=4(SNR=21,采集时间20 s)的低信噪比数据反演,BRD算法不仅出现明显的峰位偏移,其对于短弛豫组分的反演亦出现不稳定的“杂峰”现象.而UDMCA算法在相同条件下所得的反演结果依然与标签反演结果NS=256(SNR=153,采集时间1 305 s)在峰值和强度上保持着较好的一致性.除此之外,可以观察到,即使是在较高累加次数的数据条件下,BRD算法所得反演结果在弛豫谱的头部和尾部依然存在较明显的噪声干扰造成的“抖动”现象,这一现象在低信噪比条件下更加明显.而UDMCA算法即使在低信噪比条件下的反演结果依然保持着较好的平滑性,能够有效抑制噪声对弛豫谱形态的干扰.
图11
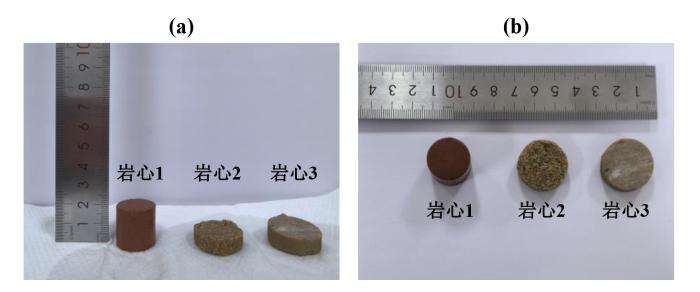
图11
实验岩心实物图. (a)侧视图;(b)俯视图
Fig. 11
Photograph of the experimental core sample. (a)Side view; (b) Top view
图12
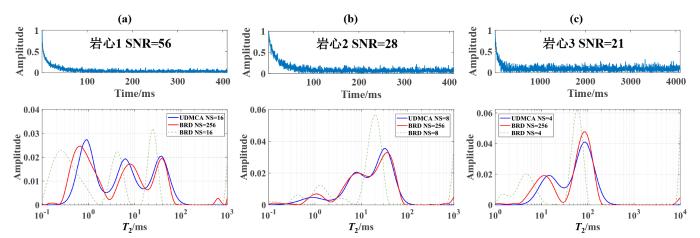
图12
UDMCA与BRD在低信噪比岩心数据下的反演结果谱与BRD在累加次数为256的高信噪比岩心数据下反演结果谱的对比. (a)红砂岩;(b)细砂岩;(c)人造砂岩
Fig. 12
Comparison of inversion spectra obtained by UDMCA and BRD for low-SNR core data with those obtained by BRD for high-SNR core data with 256 signal accumulations. (a) Red sandstone; (b) Fine sandstone; (c) Artificial sandstone
综上所述,本文提出的基于深度学习技术的UDMCA算法能够在低信噪比条件下实现准确、稳定的岩心T2谱反演结果,从而降低岩心实验对信号累加次数的依赖,有助于减少信号采集时间成本,提高实验效率.
4 结论
本文提出了一种适用于低信噪比LF-NMR弛豫谱反演的深度学习方法——UDMCA.通过正演模拟构建大规模模拟数据集对模型进行训练,并使用模拟数据与实际实验数据开展对比验证,结果表明,该方法在低信噪比条件下的T2弛豫谱反演中,无论在准确性还是稳定性方面均优于传统正则化算法;与现有深度学习方法ATT-CNN相比,UDMCA仍展现出更准确稳定的反演性能,为LF-NMR数据的处理与重建提供了一种创新且有效的解决方案.
尽管本文主要聚焦于T2弛豫时间谱的反演,但UDMCA方法的应用范围并不局限于此.该方法可以灵活扩展到其他核函数形式,如:纵向弛豫时间T1分布、扩散系数D分布等.这种普适性使得该方法能够在化学、物理、医学等多个领域都具有广阔的应用前景.
展望未来,我们将进一步探索UDMCA在不同领域中的适用性,重点关注其在地质勘探相关问题中的应用潜力.后续研究将围绕岩心分析需求,对网络结构进行针对性优化,并在数据集构建过程中引入更多物理约束,以进一步提升算法性能和复杂场景下的适应能力,为NMR数据分析提供更加完善的解决方案.
利益冲突
无
参考文献
Advances in low-field nuclear magnetic resonance (NMR) technologies applied for characterization of pore space inside rocks: a critical review
[J].
DOI:10.1007/s12182-020-00488-0
[本文引用: 1]

NMR serves as an important technique for probing rock pore space, such as pore structure characterization, fluid identification, and petrophysical property testing, due to the reusability of cores, convenience in sample processing, and time efficiency in laboratory tests. In practice, NMR signal collection is normally achieved through polarized nuclei relaxation which releases crucial relaxation messages for result interpretation. The impetus of this work is to help engineers and researchers with petroleum background obtain new insights into NMR principals and extend existing methodologies for characterization of unconventional formations. This article first gives a brief description of the development history of relaxation theories and models for porous media. Then, the widely used NMR techniques for characterizing petrophysical properties and pore structures are presented. Meanwhile, limitations and deficiencies of them are summarized. Finally, future work on improving these insufficiencies and approaches of enhancement applicability for NMR technologies are discussed.
Chert outcrops differentiation by means of low-field NMR relaxometry
[J].
DOI:10.1038/s41598-024-75945-6
PMID:39455649
[本文引用: 1]
Siliceous rocks served as raw materials in the production of stone tools from the Middle Paleolithic onwards. Due to migration, the provenance of archaeological artefacts can differ from their natural outcrop location. The aim of this work was the application of 1D and 2D low-field nuclear magnetic resonance (LF-NMR) relaxometry to distinguish cherts by their original source. Herein, bedded cherts and accompanying nodular cherts coming from three different outcrops of Kraków-Częstochowa Upland were investigated. 1D and 2D (T-T) experiments of water-saturated and dry rock sample states delivered T, T times and T/T ratios of distinct hydrogen populations - parameters sensitive to pore size, surface properties, and hydrogen bonding length. In-depth analysis of NMR data showed substantial differences in the porosity, pore surface and pore structure properties of investigated chert samples tested in the three different saturation levels (100% water-saturated, dried and differential). Finally, principal component analysis (PCA) was performed to reduce the number of correlations obtained and highlight the most important NMR properties specific to the particular outcrop localization."Please check captured corresponding author email if correct.""The email is correct".© 2024. The Author(s).
Applying NMR T2 spectral parameters in pore structure evaluation—an example from an Eocene low-permeability sandstone reservoir
[J].
DOI:10.3390/app11178027
URL
[本文引用: 1]
The Eocene low-permeability sandstone reservoirs in the Dongying Depression, Bohai Bay Basin, China host a significant amount of oil reserves. The development of the reservoirs has been hampered by our inability to understand the complex and heterogeneous pore structures of the reservoirs. In this study, the pore systems, pore sizes, pore connectivity, and movable fluid distribution of the Eocene Shahejie Formation (Es4) sandstone reservoirs were investigated using an integrated analysis of optical and scanning electron microscopy (SEM), mercury injection capillary pressure (MICP), and nuclear magnetic resonance (NMR). The full-range pore structures of the Es4 sandstone reservoirs were evaluated by using NMR experiments. Various NMR T2 spectral parameters suitable for describing the pore structures and movable fluid distribution were extracted through morphological and statistical analysis of NMR T2 spectra. In combination with corresponding MICP data and petrophysical properties, we have demonstrated the reliability and robustness of the T2 spectral parameters for pore structure characterization. Four types of pore structures (I, II, III, and IV) were distinguished from the NMR T2 spectral parameters in association with other petrophysical properties and macroscopic behaviors. We have demonstrated the effectiveness of using the NMR T2 spectral parameters to characterize and classify micropore structures, which may be applied to effectively evaluate and predict low-permeability reservoir quality.
Real-time oil-saturation monitoring in rock cores with low-field NMR
[J].
DOI:S1090-7807(15)00098-1
PMID:25996514
[本文引用: 1]
Nuclear magnetic resonance (NMR) provides a powerful suite of tools for studying oil in reservoir core plugs at the laboratory scale. Low-field magnets are preferred for well-log calibration and to minimize magnetic-susceptibility-induced internal gradients in the porous medium. We demonstrate that careful data processing, combined with prior knowledge of the sample properties, enables real-time acquisition and interpretation of saturation state (relative amount of oil and water in the pores of a rock). Robust discrimination of oil and brine is achieved with diffusion weighting. We use this real-time analysis to monitor the forced displacement of oil from porous materials (sintered glass beads and sandstones) and to generate capillary desaturation curves. The real-time output enables in situ modification of the flood protocol and accurate control of the saturation state prior to the acquisition of standard NMR core analysis data, such as diffusion-relaxation correlations. Although applications to oil recovery and core analysis are demonstrated, the implementation highlights the general practicality of low-field NMR as an inline sensor for real-time industrial process control. Copyright © 2015 Elsevier Inc. All rights reserved.
Understanding NMR spectral uncertainty
[J].DOI:10.1016/j.jmr.2010.02.010 URL [本文引用: 1]
On the solution of ill-posed problems and the method of regularization
[J].
Estimating solutions of first kind integral equations with nonnegative constraints and optimal smoothing
[J].DOI:10.1137/0718025 URL [本文引用: 2]
On the inversion of diffusion NMR data: Tikhonov regularization and optimal choice of the regularization parameter
[J].
DOI:10.1016/j.jmr.2011.05.014
PMID:21683632
[本文引用: 1]
The analysis of diffusion NMR data in terms of distributions of diffusion coefficients is hampered by the ill-posed nature of the required inverse Laplace transformation. Naïve approaches such as multiexponential fitting or standard least-squares algorithms are numerically unstable and often fail. This paper updates the CONTIN approach of the application of Tikhonov regularization to stabilise this numerical inversion problem and demonstrates two methods for automatically choosing the optimal value of the regularization parameter. These approaches are computationally efficient and easy to implement using standard matrix algebra techniques. Example analyses are presenting using both synthetic data and experimental results of diffusion NMR studies on the azo-dye sunset yellow and some polymer molecular weight reference standards.Copyright © 2011 Elsevier Inc. All rights reserved.
A fast iterative shrinkage-thresholding algorithm for linear inverse problems
[J].DOI:10.1137/080716542 URL [本文引用: 1]
Laplace inversion of low-resolution NMR relaxometry data using sparse representation methods
[J].DOI:10.1002/cmr.a.v42.3 URL [本文引用: 1]
Nuclear magnetic resonance spectrum inversion based on the residual hybrid L1/L2 norm
[J].DOI:10.1109/LGRS.2018.2835457 URL [本文引用: 1]
Low-field NMR inversion based on low-rank and sparsity restraint of relaxation spectra
[J].DOI:10.1016/j.petsci.2022.10.020 URL [本文引用: 1]
T2 analysis using artificial neural networks
[J].DOI:10.1016/j.jmr.2021.106930 URL [本文引用: 1]
A study on multi-exponential inversion of nuclear magnetic resonance relaxation data using deep learning
[J].DOI:10.1016/j.jmr.2022.107358 URL [本文引用: 2]
High-quality reconstruction for Laplace NMR based on deep learning
[J].DOI:10.1021/acs.analchem.3c00537 URL [本文引用: 1]
Trading sensitivity for information: Carr-Purcell-Meiboom-Gill acquisition in solid-state NMR
[J].DOI:10.1063/1.3463653 URL [本文引用: 1]
Quantitative interpretation of NMR relaxation data
[J].
U-Net: Convolutional networks for biomedical image segmentation
[C]//
Comparing U-Net based models for denoising color images
[J].DOI:10.3390/ai1040029 URL [本文引用: 1]


