引言
可变形配准(Deformable Image Registration,DIR)作为医学影像分析任务的基础,在疾病诊断[1 ,2 ] 、手术导航[3 ] 、放射治疗[4 ] 、运动建模[5 ] 和图谱分析[6 ] 等领域应用广泛.它通过建立两幅图像间的非线性空间对应关系,将图像转换到一个共同坐标系下,实现图像间的对齐.传统配准方法依赖显式特征建立不同图像的几何关联,这些特征通常是人为设计.另外,传统方法对于每一对新输入的图像都需要重新求解,导致优化过程耗时且易陷入局部最优解.
随着深度学习技术在图像分割、图像重建等众多计算机视觉任务中展现出优越的性能,一些研究学者将其引入医学图像配准中[7 ] .根据训练方式的不同,基于深度学习的配准可分为半监督配准、全监督配准和无监督配准三种[8 ] .前两类方法需要真实的变形场作为标签数据,而这些数据通常由传统算法生成或人工标注,获取成本高且存在一定误差.而无监督配准模型训练时无需真实的变形场,避免了对标签数据的依赖,只需要提供一对图像就可以预测变形场.因此,基于无监督学习的配准方法受到了广泛关注. Balakrishnan等人[7 ] 设计了一个无监督配准通用模型VoxelMorph,该模型分为U-Net网络和空间变换网络(Spatial Transformer Networks,STN)[9 ] 两部分,U-Net负责生成变形场,STN则根据变形场对运动图像进行变形得到配准后的图像.CycleMorph[10 ] 是一种循环一致可变形配准方法,该方法训练了两个卷积神经网络(Convolutional Neural Networks,CNN),分别生成正向和反向变形场,并引入循环一致性损失以保证图像的拓扑结构.Mok等人[11 ] 提出一个基于CNN的对称微分同胚配准模型SYMNet,该方法通过一个中间变形场估计两幅图像间正向和反向变换,保证变换的可逆性和拓扑结构.以上方法基于CNN实现,它们使用固定大小的卷积核,有限的感受野只能提取局部的信息,对远距离空间的建模能力存在局限性.
近年来,学者们在网络中引入Transformer架构[12 ] 以建模远距离空间依赖关系.Transformer架构将输入图像分成多个patch,利用自注意力机制,通过查询(Query)、键(Key)和值(Value)矩阵计算每个patch与其他patch的相关性,使得该patch获得全局信息.Dosovitskiy等人[13 ] 受其启发于2020年提出了Vision Transformer(ViT)模型,ViT模型将输入图像划分为固定大小的patch并映射为token,对于每个token给予一个可学习的位置编码和class token,然后传入Transformer模块并通过多层感知机头(Multilayer Perceptron Head,MLP Head)得到最终结果.Chen等人[14 ] 将CNN和ViT模型结合设计了CNN-Transformer混合架构的模型Vit-V-Net,进一步提高了配准精度.在此基础上,Chen等人[15 ] 进一步提出TransMorph模型,编码器使用Swin Transformer[16 ] ,利用窗口注意力替代ViT模型的全局注意力,并且不需要额外的位置编码,降低参数量的同时提升了配准性能.后续的一些方法基于Transformer架构进行改进.Shi等人[17 ] 提出一种纯Transformer架构网络XMorpher,设计两个并行的特征提取网络分别提取固定图像和运动图像的特征,并通过交叉注意力模块建立两幅图像的对应关系,促进特征的高效融合. Zheng等人[18 ] 将互注意力机制和递归网络结合,扩大感受野,对可变形配准进行逐步细化.Wang等人[19 ] 利用多头邻域注意力机制显式分解不同的运动模态,再通过竞争加权模块融合多个变形子场,实现由粗到细的配准.Chen等人[20 ] 设计双流特征提取分支,结合局部窗口自注意力和局部窗口交叉注意力实现图像间特征的显式匹配.
CNN通过固定卷积核获得局部感受野以提取特征空间,扩大感受野的方式为层级堆叠或者使用膨胀卷积,在参数量和计算效率方面具有优势.但受限于有限的感受野以及相同的卷积核权重,CNN方法难以建立图像间长距离的非线性空间映射,当图像存在大尺度形变或者复杂的非线性形变等情况时CNN方法的表现受限.而基于Transformer架构的方法通过自注意力机制显式建模任意特征间的相关性,让网络在全局范围内捕获空间对应关系,更适合处理大尺度形变和非线性形变,这一点弥补了CNN的不足,但通常会伴随更高的计算开销.因此,Liu等人[21 ] 根据Transformer架构的理念提出了纯卷积网络ConvNeXt,为建模远距离依赖关系,采用大卷积核替代传统的3×3卷积核,有效扩大了感受野,并采用深度可分离卷积代替标准卷积,极大降低了网络计算量.然而,医学图像尤其脑部三维MRI为高维数据,使用大核卷积对显存和算力提出极高要求,此外,ConvNeXt每层编码使用单一大小的大核卷积,易导致局部细节丢失.
基于上述背景,本文提出了一种基于多尺度膨胀残差卷积和双重注意力的三维可变形配准网络(MDDA-Net).该网络通过多尺度膨胀残差卷积模块在不引入过多参数的基础上扩大感受野,高效提取多尺度特征;设计通道-空间双重注意力模块,过滤图像中的冗余信息,实现特征增强;引入动态上采样模块,避免传统插值导致的棋盘伪影,提高变形场质量.本研究主要贡献如下:
(1)设计多尺度膨胀残差卷积模块,将深度可分离卷积和膨胀卷积结合以扩大感受野,捕获多尺度特征.
(2)构建双重注意力模块,通过高效通道注意力和分组空间注意力的联合建模,增强特征表示.
(3)引入动态上采样模块,构造动态采样网格自适应调整采样位置,防止结构模糊或失真,提高网络配准精度.
1 实验部分
1.1 整体网络
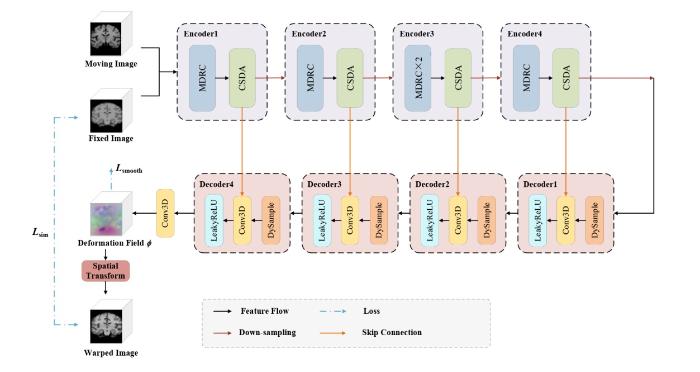
本文提出的MDDA-Net网络框架如图1 所示,整体框架为编码器-解码器的U型结构,首先,将固定图像和运动图像在通道维度拼接作为输入,在编码器阶段,先通过多尺度膨胀残差卷积模块(MDRC)捕获多尺度特征信息,每层编码器使用不同膨胀率的卷积扩大感受野.然后,采用双重注意力模块(CSDA)抑制冗余信息,对关键区域的特征进一步增强.之后经过动态上采样模块(Dysample)恢复图像分辨率,并与编码器经跳跃连接后的特征拼接.最后,利用空间变换函数对运动图像施加几何变形,生成配准后的图像.网络通过最小化损失函数促使运动图像和固定图像对齐,实现最佳配准.损失函数包括相似性损失L sim 和正则化损失L smooth ,前者用于衡量经变形场变形后的运动图像和固定图像的对齐程度,后者用于保证变形场的平滑性.图像通过MDDA-Net各模块时的输入与输出维度详见附录表A1 .
图1
图1
MDDA-Net整体框架
Fig. 1
Overall framework of MDDA-Net
1.2 多尺度膨胀残差卷积模块
现有经典配准方法如VoxelMorph[7 ] 、CycleMorph[10 ] 等在编码器阶段均使用标准卷积提取特征,但标准卷积受限于固定的感受野,难以有效捕捉脑部图像复杂的局部形变信息,导致大变形解剖区域配准效果不佳.因此,本研究设计了多尺度膨胀残差卷积模块(Multi-Dilated Residual Convolution Module,MDRC),充分扩大卷积的感受野以捕获更多的上下文信息,提升网络捕获变形的能力.
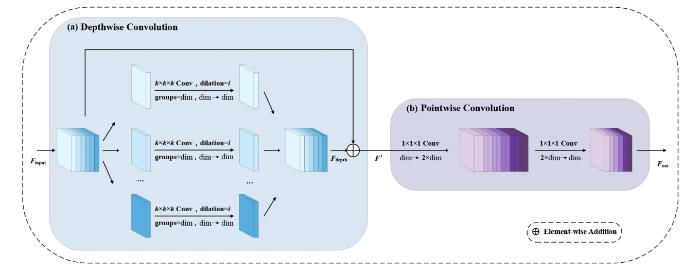
结构如图2 所示,整体模块为一个深度可分离卷积[22 ] ,其采用解耦设计将通道信息和空间信息分离.对于输入的特征F input ,首先经过深度卷积对每个输入通道单独处理以提取空间维度信息.考虑到膨胀卷积能够在扩大感受野的同时不增加网络的参数和计算量,因此将深度卷积中的普通卷积替换为膨胀卷积,每层编码器使用不同的膨胀率高效捕获多尺度信息,并使用残差连接防止梯度爆炸和消失.随后,通过两个1×1×1卷积对深度卷积部分残差连接后的输出${F}^{\prime }$ [21 ] ,即优先进行深度卷积以降低计算量,接着在两个逐点卷积中将维度扩展为输入维度的2倍,达到充分融合深度卷积提取空间信息的目的,最后再将通道数压缩回原始维度,减少冗余信息,得到输出特征${F}_{\text{out}}$
(1) ${F}_{\text{depth}}={\text{DWConv}}_{3\times 3\times 3}^{d}({F}_{\text{input}})$
(2) ${F}^{\prime }={F}_{\text{input}}+{F}_{\text{depth}}$
(3) ${F}_{\text{out}}={\text{PWConv}}_{1\times 1\times 1}^{\text{2}\times \text{dim}\to \text{dim}}({\text{PWConv}}_{1\times 1\times 1}^{\text{dim}\to \text{2}\times \text{dim}}({F}^{\prime }))$
其中,${\text{DWConv}}_{3\times 3\times 3}^{d}(\cdot)$ d 的深度卷积,${F}_{\text{depth}}$ ${F}^{\prime }$ ${\text{PWConv}}_{1\times 1\times 1}^{{C}_{\text{in}}\to {C}_{\text{out}}}(\cdot)$ ${C}_{\text{in}}$ ${C}_{\text{out}}$
图2
图2
多尺度膨胀残差卷积模块. (a)深度卷积;(b)逐点卷积
Fig. 2
Multi-dilated residual convolution module. (a) Depthwise convolution; (b) Pointwise convolution
1.3 通道-空间双重注意力
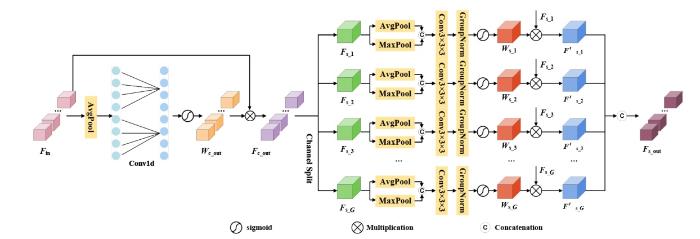
大脑在不同解剖区域具有不同的特征,且脑部3D数据存在冗余信息较多,为了高效提取不同脑区特征并抑制无关信息的干扰,本文在MDRC模块后设计了通道-空间双重注意力模块(Channel-Spatial Dual Attention,CSDA),其结构如图3 所示,包括通道注意力和分组空间注意力两部分,采用串联形式将两者结合.通道注意力模块中,对输入特征${F}_{\text{in}}$ σ )将其范围映射在(0,1)内.公式如下:
(4) Wc_out =$\left.\sigma\left\{\text { Convld[AvgPool }\left(F_{\text {in }}\right)\right]\right\}$
Wc_out 为使用激活函数映射得到的通道注意力权重.Convld的卷积核大小k 根据通道数自适应计算以动态调整各个通道的权重,公式如下:
(5) $k={\left|\frac{{\mathrm{log}}_{2}C+b}{\gamma }\right|}_{\text{odd}}$
$|\cdot {|}_{\text{odd}}$ C 表示通道数,b 和γ 为超参数,取值分别为1和2.最后通道注意力权重${W}_{\text{c_out}}$ ${F}_{\text{in}}$ ${F}_{\text{c_out}}$
(6) ${F}_{\text{c_out}}={W}_{\text{c_out}}\otimes {F}_{\text{in}}$
经通道注意力模块加权后的特征作为空间注意力模块的输入,在空间注意力模块中,本文使用了分组形式,将特征分成G 组,每组包含C /G 个通道,每组特征用${F}_{\text{s_}i}$ ( i =1,2,……,G )表示,这样设计的目的在于引导不同通道专注于脑部不同区域的特征.网络第一层CSDA的分组数G 取2,后面三层的G 均设为4.接着,每组特征分别经过平均池化(AvgPool)和最大池化(MaxPool)操作后沿通道维度拼接(concat),平均池化反映特征整体趋势,最大池化则强调显著特征,两者结合能使注意力同时关注局部和全局信息,提高模型的配准精度.拼接后通过3×3×3卷积(Conv3d)、组归一化(GroupNorm)和sigmoid激活函数(σ )生成分组空间注意力${W}_{\text{s_}i}$ ( i =1,2,……,G ),公式表示如下:
(7) ${W}_{\text{s_}i}=\sigma \left\{\text{GroupNorm[Conv3d(concat(AvgPool(}{F}_{\text{s_}i}\text{),}\text{ }\text{MaxPool(}{F}_{\text{s_}i}\text{)))]}\right\}$
然后,空间注意力${W}_{\text{s_}i}$ ${F}_{\text{s_}i}$ ${F}_{\text{s_out}}$
(8) ${{F}^{\prime }}_{\text{s_}i}^{}={W}_{\text{s_}i}\otimes {F}_{\text{s_}i}$
(9) ${F}_{\text{s_out}}^{}=\text{concat}({{F}^{\prime }}_{\text{s_1}},{{F}^{\prime }}_{\text{s_2}},\text{ }{{F}^{\prime }}_{\text{s_3}},\dots \dots,\text{ }{{F}^{\prime }}_{\text{s_}G})$
图3
图3
通道-空间双重注意力模块
Fig. 3
Channel-spatial dual attention module
1.4 动态上采样
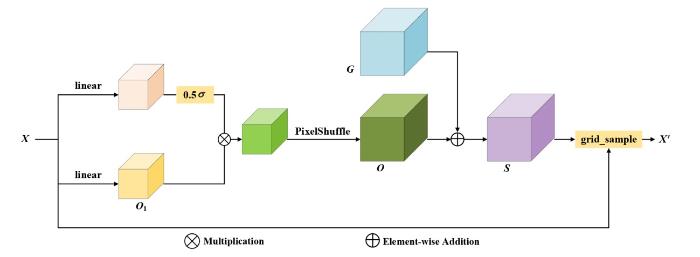
上采样模块位于网络的解码器部分,用于恢复图像分辨率并与同级经过跳跃连接的编码器特征进行融合.在基于深度学习的医学图像配准中,上采样的特征会影响后续变形场的准确性.最邻近插值、双线性插值等传统上采样方法通过简单的局部插值得到上采样后的图像,但前者会产生锯齿状伪影,后者会导致边缘模糊,均会影响配准的精度.因此,本文引入Dysample[23 ] 进行上采样,如图4 所示.与CARAFE[24 ] 、FADE[25 ] 此类基于动态核的上采样不同,Dysample利用动态采样点建模几何信息并结合PyTorch内置函数grid_sample实现上采样,具有更少计算量FLOPs和参数数量Params.具体来说,先通过双线性初始化获得初始采样位置G ,目的在于当偏移量为零时保证网络输出与双线性插值结果一致,防止初始分布不均匀导致模型训练不稳定.接着输入特征X 分别通过线性投影linear生成原始偏移${O}_{1}$ σ )对原始偏移范围进行约束,避免采样点重叠导致边界产生伪影[23 ] .然后通过PixelShuffle对其重塑得到最终的偏移量O .整个过程表示为:
(10) ${O}_{1}=\text{linear}\text{ }(X)$
(11) $\text{factor}=0.5\sigma (\text{linear}\text{ }(X))$
(12) $O=\text{PixelShuffle}({O}_{1}\times \text{factor})$
图4
图4
动态上采样模块
Fig. 4
Dynamic upsampling module
之后将偏移量O 和初始采样位置G 相加,动态调整采样位置以自适应采样,提高上采样的质量.最后,通过grid_sample函数对点采样集S 计算得到上采样后的特征${X}^{\prime }$
(13) $S=O+G$
(14) ${X}^{\prime }=\text{grid_sample(}X\text{,}\text{ }S\text{)}$
另外,在上采样过程中沿通道维度将特征图划分为g 组,每组特征生成独立的偏移量,提升模型对不同区域的表达能力.
1.5 损失函数
配准的目的是生成一个最佳坐标变换,使损失函数最小化.损失函数分为两部分,一是计算配准后图像与固定图像间的相似性,二是对生成的变形场ϕ 进行空间正则化,以平滑变形场.形式如下:
(15) $\hat{\phi}=\arg \min _{\phi} L\left(I_{\mathrm{f}}, I_{\mathrm{m}}, \phi\right)$
(16) $L({I}_{\text{f}},{I}_{\text{m}},\phi)={L}_{\text{sim}}({I}_{\text{f}},{I}_{\text{m}}\circ \phi)+\lambda {L}_{\text{smooth}}(\phi)$
其中,$\widehat{\phi }$ ${I}_{\text{m}}\circ \phi $ $\phi $ ${L}_{\text{sim}}(\cdot)$ ${L}_{\text{smooth}}(\cdot)$ $\lambda $
本文使用归一化互相关(Normalized cross correlation,NCC)[26 ] 作为相似性函数来优化图像间的相似性:
(17) $\text{NCC}({I}_{\text{f}},{I}_{\text{m}}\circ \phi)={\displaystyle \sum _{p\in \Omega }\frac{({\displaystyle {\sum }_{{p}_{\text{i}}}(}{I}_{\text{f}}({p}_{\text{i}})-{\overline{I}}_{\text{f}}(p))([{I}_{\text{m}}\circ \phi ]({p}_{\text{i}})-[{\overline{I}}_{\text{m}}\circ \phi ]{(p)))}^{2}}{({\displaystyle {\sum }_{{p}_{\text{i}}}(}{I}_{\text{f}}({p}_{\text{i}})-{\overline{I}}_{\text{f}}{(p))}^{2})({\displaystyle {\sum }_{{p}_{\text{i}}}(}[{I}_{\text{m}}\circ \phi ]({p}_{\text{i}})-[{\overline{I}}_{\text{m}}\circ \phi ]{(p))}^{2})}}$
(18) ${L}_{\text{sim}}({I}_{\text{f}},{I}_{\text{m}}\circ \phi)=-\text{NCC}({I}_{\text{f}},{I}_{\text{m}}\circ \phi)$
其中,Ω 表示图像域,${\overline{I}}_{\text{f}}(p)$ $[{\overline{I}}_{\text{m}}\circ \phi ](p)$ p 为中心、大小为${n}^{3}$ ${p}_{\text{i}}$ p 为中心的局部邻域,实验中n 的取值为9.
优化相似性损失函数可以使配准后图像最大程度和固定图像相似,但得到的变形场不一定是光滑的,因此,在变形场的空间梯度上使用扩散正则化保证合理的变形.本文选用L2范数[7 ] 来约束变形场的平滑性:
(19) ${L}_{\text{smooth}}(\phi)={\displaystyle \sum _{p\in \Omega }\left|\right|}\nabla \phi (p)|{|}^{2}$
(20) $\nabla \phi (p)=\left(\frac{\partial \phi (p)}{\partial x},\frac{\partial \phi (p)}{\partial y},\frac{\partial \phi (p)}{\partial z}\right)$
其中,$\nabla \phi (\cdot)$ p 点变形场$\phi $ $\frac{\partial \phi (p)}{\partial x}$ $\frac{\partial \phi (p)}{\partial y}$ $\frac{\partial \phi (p)}{\partial z}$ x 、y 、z 方向上的梯度,利用相邻体素之间的差异来近似梯度.
2 实验设置
2.1 数据集
本实验使用两个公开可用的脑部磁共振数据集IXI和LPBA40对各个模型进行实验评估.
IXI(Information eXtraction from Images)数据集[15 ] 共包含576张T 1 加权脑部MR图像,按照7 : 1 : 2的比例划分为训练集、验证集和测试集,即分别使用403、58和115张图像进行训练、验证和测试.对于IXI数据集,本文进行了基于图谱的配准,选择Kim等人[10 ] 提供的脑图谱MRI作为运动图像.所有扫描图像均使用FreeSurfer[27 ] 进行预处理,包括颅骨剥离、重采样、仿射对齐及裁剪和归一化等步骤,所有图像尺寸裁剪为160×192×224,并使用专家标注的30个感兴趣区域(region of interest,ROI)的标签图来评估配准算法的性能.
LPBA40数据集[28 ] 包含40张T 1 W脑部MRI,划分为训练集28张,验证集4张以及测试集8张,选择S01作为固定图像进行基于图谱的配准.所有图像均通过FreeSurfer软件预处理,具体操作同IXI,最后将图像大小裁剪为160×192×160,分辨率设为1 mm×1 mm×1 mm,并勾画56个ROI评估配准性能.
2.2 实验细节
本实验选择了传统配准SyN[29 ] 、NiftyReg[30 ] 以及深度学习经典算法VoxelMorph[7 ] 、CycleMorph[10 ] 、Vit-V-Net[14 ] 、TransMorph[15 ] 作为对比方法,所有模型均在配备NVIDIA RTX3090(24G)显卡的PC上使用PyTorch框架实现,使用Adam优化算法,IXI数据集训练500 epochs,LPBA40数据集训练1 000 epochs.两个数据集的学习率设置为1×10⁻⁴ ,batchsize为1.在训练过程中,对脑部MRI数据集进行数据随机翻转,实现数据增强.训练超参数的设置详见附录表A2 .
2.3 评价指标
本文采用戴斯相似性系数(Dice similarity coefficient,DSC)[31 ] 、95%的豪斯多夫距离(95% Hausdorff Distance,HD95)[32 ] 、非正雅可比行列式的百分比(%$\left|{J}_{\phi }\right|$
DSC根据配准后图像与固定图像对应ROI的重叠程度来量化两幅图像的相似性,具体定义如下:
(21) $\text{DSC}=\frac{2|{S}_{\text{w}}(k)\cap {S}_{\text{f}}(k)|}{|{S}_{\text{w}}(k)|+|{S}_{\text{f}}(k)|}$
其中,${S}_{\text{f}}$ ${S}_{\text{w}}$ k 表示ROI的个数.DSC的值介于0~1,越高表明两幅图像的ROI重叠程度越高,配准效果越好.
雅可比行列式反映了图像中各个像素点发生变形的情况,用于评价变形场的平滑效果.公式如下:
(22) $\text{det(}{J}_{\phi }\text{(}p\text{))}=\left|\begin{array}{ccc}\frac{\partial {\phi }_{\text{x}}(p)}{\partial x}& \frac{\partial {\phi }_{\text{x}}(p)}{\partial y}& \frac{\partial {\phi }_{\text{x}}(p)}{\partial z}\\ \frac{\partial {\phi }_{\text{y}}(p)}{\partial x}& \frac{\partial {\phi }_{\text{y}}(p)}{\partial y}& \frac{\partial {\phi }_{\text{y}}(p)}{\partial z}\\ \frac{\partial {\phi }_{\text{z}}(p)}{\partial x}& \frac{\partial {\phi }_{\text{z}}(p)}{\partial y}& \frac{\partial {\phi }_{\text{z}}(p)}{\partial z}\end{array}\right|$
其中,$\text{det(}\cdot \text{)}$ ${J}_{\phi }\text{(}p\text{)}$ ϕ 在p 点的雅可比矩阵.当雅可比行列式的值小于0,说明在p 点产生了折叠.非正雅可比行列式的百分比越小,表明变形场存在的折叠区域少,质量越高.
豪斯多夫距离HD用于测量固定和配准后图像的解剖结构之间的最长距离.定义为:
(23) $\text{HD(}{S}_{\text{w}}\text{,}{S}_{\text{f}}\text{)}=\mathrm{max}(h({S}_{\text{w}}\text{,}{S}_{\text{f}}),h({S}_{\text{f}}\text{,}{S}_{\text{w}}))$
(24) $h\text{(}{S}_{\text{w}}\text{,}{S}_{\text{f}}\text{)}=\underset{{P}_{\text{W}}\in {S}_{\text{W}}}{\mathrm{max}}\underset{{P}_{\text{f}}\in {S}_{\text{f}}}{\mathrm{min}}\left|\right|{P}_{\text{w}}-{P}_{\text{f}}\left|\right|$
(25) $h\text{(}{S}_{\text{f}}\text{,}{S}_{\text{w}}\text{)}=\underset{{P}_{\text{f}}\in {S}_{\text{f}}}{\mathrm{max}}\underset{{P}_{\text{W}}\in {S}_{\text{W}}}{\mathrm{min}}\left|\right|{P}_{\text{f}}-{P}_{\text{w}}\left|\right|$
其中,${P}_{\text{w}}$ ${P}_{\text{f}}$ ${S}_{\text{w}}$ ${S}_{\text{f}}$ h (•)为两者的欧式距离. HD95即取前95% 的距离值来作为最终结果,避免异常值对结果的影响,该值越小越好.
参数量和计算量通过PyTorch内置函数进行计算.内存(Memory)表示模型配准一对图像时内存的使用情况.配准时间(Time)表示模型配准一对图像所需要的时间.传统配准方法的时间为基于CPU的计算时间,深度学习配准方法为基于GPU计算时间.本文的配准时间取测试集数据的平均值.
该小节和损失函数一节涉及多种常用的医学图像配准数学符号,为便于阅读,已将涉及的主要符号及其含义总结于附录表A3 .
3 实验结果与分析
3.1 对比实验
在两个不同的数据集上进行基于图谱的配准,将本文提出的模型与SyN[29 ] 、NiftyReg[30 ] 、VoxelMorph-1[7 ] 、VoxelMorph-2[7 ] 、CycleMorph[10 ] 、Vit-V-Net[14 ] 及TransMorph[15 ] 比较并进行定量和定性分析.其中,SyN和NiftyReg为基于迭代优化的经典传统配准算法,VoxelMorph-1、VoxelMorph-2以及CycleMorph是基于CNN的深度学习配准方法,Vit-V-Net和TransMorph是基于Transformer的深度学习配准方法.表1 和表2 是不同配准模型在IXI数据集和LPBA40数据集上的定量结果,粗体表示最优结果.
从表1 可以看出,在IXI数据集上,基于深度学习的配准方法的DSC值均比传统配准方法的高.具体来说,本文模型在所有方法中取得了最佳DSC值,达到0.751且具有最小的标准差,比次优方法TransMorph提高了0.94%.MDDA-Net的HD95最低,为2.107 mm,说明本文方法得到的配准后图像与固定图像的相似性最高.此外,本文提出的网络虽没有取得最佳的非正雅可比行列式,比传统配准方法略高,但在基于深度学习的配准方法中,本文模型生成的变形场的折叠率为最低,说明拓扑结构破坏更少,实现了更平滑的变形.与VoxelMorph-1和VoxelMorph-2相比,本文虽同为 CNN 模型但加入了多尺度膨胀残差卷积模块及动态上采样模块,故参数量、计算量和内存有所增加.CycleMorph为实现循环一致性构建了双重CNN,两次前向传播的激活值叠加导致内存增大,而本文模型只进行单次前向传播,故本文模型具有更低的内存占用.与Vit-V-Net、TransMorph使用注意力的方法相比,本文加入注意力机制后,参数量减少的同时实现了DSC的提升.在时间Time这一指标上,本文模型达到了次优的配准速度.从表2 的定量结果可以发现,MDDA-Net在LPBA40数据集上的DSC和HD95分别达到0.673和1.104 mm,为所有模型里的最优值,非正雅可比行列式百分比(%|Jϕ |≤0)的值为0.507%,在基于深度学习的方法中取得最佳结果,仅次于SyN. 本文模型DSC与VoxelMorph-1相比提高了3.54%,与基于Transformer的配准方法(如TransMorph)相比优化了0.75%且参数量明显降低.与传统方法相比,本文模型的非正雅可比行列式百分比略差,但DSC和HD95具有一定优势.传统配准算法在非正雅可比行列式上显著优于基于深度学习的配准方法,是因为其基于微分同胚框架实现配准,根据常微分方程理论,模型生成的速度场几乎不会出现折叠,而对比方法中的基于深度学习的配准方法以及本文模型未设计显式的微分同胚约束,仅在损失函数中使用正则化项进行约束,该项无法提供严格的拓扑保证,因此仍会存在一定比例的非正雅可比行列式.此外,基于CNN的模型(VoxelMorph-1、VoxelMorph-2、CycleMorph及本文模型)在参数量上更具优势,而基于Transformer的模型(Vit-V-Net、TransMorph)因使用了全局注意力机制,参数量显著增加.本文模型具有较大的计算量和较高的内存占用,这是因为使用了多个MDRC,尤其是该模块在网络第三层堆叠了两次,比其他CNN模型的单次卷积更复杂.Dysample需要为每一个像素预测偏移量并据此构建动态采样网格,这一过程产生大量的可学习参数和中间张量也导致计算量和内存增加.在时间方面,本文模型在LPBA40数据集上仅比VoxelMorph-1增加了0.030 s,但DSC值有一定优势.
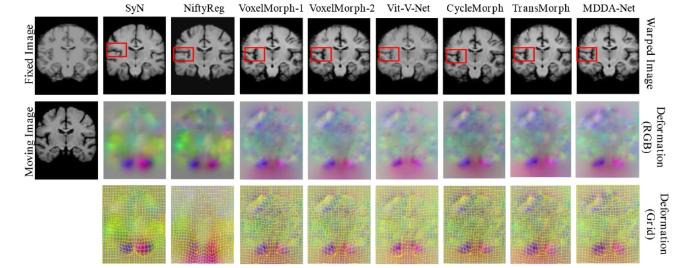
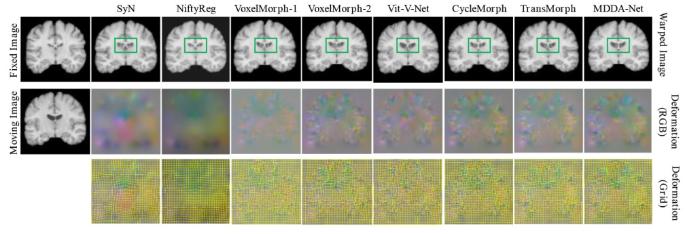
图5 展示了多种配准方法在IXI数据集冠状面上的可视化结果,由上到下分别为各种方法配准后图像、变形场(RGB显示)、变形场(Grid显示).在第一行图像中,可以观察到SyN生成的配准图像在右上角存在缺陷区域,其他模型的配准后图像则没有.图中红色方框区域,SyN和NiftyReg生成的脑沟存在一定程度的细节丢失,这可能是变形场过度平滑导致的,而本文方法生成的脑沟更细致.观察第二和第三行的图像,可以发现MDDA-Net的变形场相对于其他基于深度学习方法更加平滑,折叠区域明显减少,证明MDDA-Net折叠率更低,能够生成更合理的变形.图6 为LPBA40的可视化结果,同样展示了冠状面的配准结果和变形场,观察绿色方框脑室区域,传统方法的脑室区域较模糊,MDDA-Net的脑室区域则更加完整和清晰,取得了较好的配准效果,并且变形场的折叠体素较少.
图5
图5
不同配准模型在IXI数据集上的可视化结果
Fig. 5
Visualization results of different registration models on the IXI dataset
图6
图6
不同配准模型在LPBA40数据集上的可视化结果
Fig. 6
Visualization results of different registration models on the LPBA40 dataset
3.2 消融实验
3.2.1 MDRC、CSDA和Dysample的有效性
本实验在IXI数据集上进行消融实验,以验证MDRC、CSDA和Dysample的有效性,所有模块进行消融时保持网络配置一致.结果如表3 所示,没有添加任何模块时,baseline的DSC、HD95、非正雅可比行列式百分比的值分别为0.730,2.146 mm和1.645%.比较添加单个模块的网络性能,仅添加MDRC和单独使用CSDA时,DSC分别提升至0.737和0.734,并且变形场具有更低的折叠率,这表明MDRC与标准卷积相比,能够捕捉不同尺度的特征信息,增强了网络对上下文信息的感知能力;CSDA则通过双维度的特征增强,有效抑制冗余信息.观察参数量、计算量和内存三项指标,可以发现加入CSDA模块后尽管内存占用有所上升,但其在不显著增加参数和计算量的前提下取得了比baseline更高的DSC且耗时更短.MDRC模块中堆叠了多个深度可分离卷积并引入反向瓶颈设计,参数量和计算量较baseline的单个卷积块有所增加,同时串行结构需要保存多个中间激活层以便网络反向传播时计算梯度,因此内存也会增加.当仅使用Dysample时,DSC提高了2.05%,非正雅可比行列式百分比的值降至1.533%,这表明Dysample通过动态调整采样位置,提高上采样特征质量,有助于生成更好的变形场.这一过程中涉及大量的坐标变换,因此使用Dysample时计算量和内存上升.当同时添加两个模块,同时使用MDRC和CSDA与baseline、单独使用MDRC、单独使用CSDA相比,DSC和非正雅可比行列式百分比都进一步提升,证明两两模块结合的有效性.同样地,同时使用MDRC和Dysample以及同时使用CSDA和Dysample,网络性能均有所提升.最后,当三个模块一起使用时,网络性能达到最佳,DSC较基线提升了2.88%,HD95减小了0.039 mm,非正雅可比行列式百分比由1.645%降至1.384%,这说明三个模块协同作用,在编码器部分利用MDRC和CSDA提取丰富的特征信息并提升重要特征的表达能力,同时解码器采用Dysample生成更平滑的变形场,减少折叠区域,实现了最优配准.
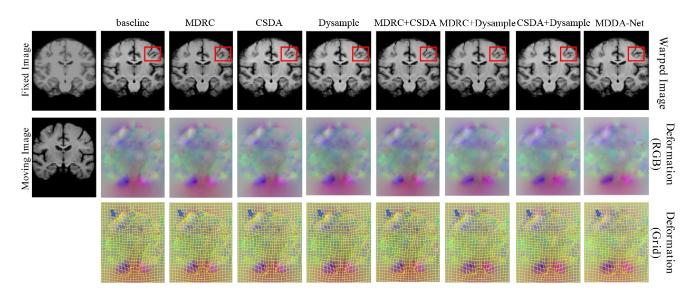
图7 为各模块在IXI数据集上消融的可视化结果,选取冠状面进行展示.红色方框标注区域,与baseline相比,添加MDRC和CSDA后,图像的局部细节更加清晰和完整,表明MDRC能充分提取局部特征和上下文信息,而CSDA则对特征进行选择与增强,显著增强网络的特征表达能力.使用Dysample时,可以观察到变形场的折叠区域较baseline减少,这说明动态上采样的方式有助于生成高质量的变形场.两个模块联合使用则进一步改善配准的效果,而同时将三个模块加入到网络中,蓝色箭头指示的变形场区域,MDDA-Net的折叠像素最少,说明保持了良好的拓扑结构,且配准后图像与固定图像在结构上更为相似,这与表3 中定量指标的结果一致.
图7
图7
消融实验定性结果
Fig. 7
Qualitative results of the ablation experiments
3.2.2 与不同多尺度结构对比
MDRC目的在于提取多尺度特征,为验证其优越性,将MDRC与ASPP[33 ] 对比.ASPP使用多个并行膨胀卷积捕获多尺度的上下文信息,MDRC则通过串行、逐层递增膨胀率的方式构建多尺度感受野.表4 展示了两者的对比结果.根据表4 的各项指标可以发现,MDRC和ASPP的DSC值相同,但ASPP的HD95和非正雅可比行列式百分比明显比MDRC差,其HD95为2.124 mm,非正雅可比行列式百分比的值达到1.506%,说明存在明显折叠区域.本文设计的MDRC在参数量、计算量、内存及时间等方面均优于ASPP. 根据ASPP的结构可以推测,其使用并行分支,每个分支具有不同的膨胀率,这会导致膨胀率较大的卷积核提取到的特征更稀疏且不连续,使得经解码器上采样后的变形场不够平滑.其并行分支在拼接前需保存多个分支的临时特征图,导致内存占用高、耗时长.同时,多分支的普通卷积比深度可分离卷积具有更多的计算参数,因此ASPP的参数量和计算量的值比MDRC高.而MDRC采用串行、渐进式的方式进行多尺度建模,使每一层都在上一层提取的特征的基础上进一步扩大范围,更利于捕捉细微的形变,降低计算负担的同时保证配准精度.
3.2.3 与不同注意力机制对比
本文所设计的注意力模块CSDA旨在高效建模通道和空间双维度上的特征,增强网络对关键解剖区域的感知能力.为了验证CSDA的优越性,将CSDA替换为CBAM[34 ] 和SE[35 ] 注意力模块进行对比分析.结果如表4 所示,本文的CSDA模块在参数量和计算量相近的情况下,DSC、HD95和非正雅可比行列式百分比的值等多个指标上均取得了最佳结果.DSC较CBAM、SE提升了0.81%和0.54%,HD95减小了2.90%和2.05%.SE注意力机制将空间维度进行压缩后使用全连接层学习通道间的相关性,模型会更加关注通道信息而忽略空间信息;CBAM则在通道注意力的基础上进一步引入空间注意力,同时关注通道和空间信息,但空间注意力对所有的通道使用统一的空间权重,容易忽略不同通道间的差异.而CSDA在通道注意力部分使用一维卷积实现跨通道特征提取,避免全连接层带来的计算开销,空间注意力部分分成多组独立的空间注意力,对不同特征分配不同权重,更有效地捕捉关键特征,提升配准精度.值得注意的是,CBAM和本文设计的CSDA同为通道-空间双维度注意力模块,两者在参数量、计算量和内存占用方面的结果相近,但CSDA的配准时间略优于CBAM,实现了更高的计算效率,展现了本文模块的有效性.
3.2.4 与不同上采样方式对比
上采样方式会影响变形场的生成效果,本实验将Dysample与nearest、trilinear对比以验证Dysample的优越性.nearest将距离最近的像素值作为采样点的像素值,计算开销更低但会导致局部不够光滑,产生锯齿状伪影;trilinear通过对周围8个像素点的值加权平均来计算目标值,能产生更平滑的结果,但由于权重取决于距离而非特征相关性,边缘处会出现过度平滑或模糊.Dysample则利用动态采样点构建采样网格,根据局部语义自适应调整采样位置实现对不同区域的配准.对比结果见表4 ,与nearest、trilinear相比,Dysample的DSC值显著提升,分别优化了1.62%和1.49%,HD95减小至2.107 mm,同时非正雅可比行列式百分比的值为1.384%,为三者中的最小值,表明Dysample生成的变形场具有最小的折叠区域.这说明nearest、trilinear的固定插值容易产生折叠,Dysample的动态插值则有效约束了变形场的折叠率.在效率方面,nearest和trilinear为固定插值,无需动态生成采样网格,故计算开销和内存更低.Dysample因引入动态采样点导致参数量、计算量和内存占用增加,但配准时间仅比trilinear增加0.013 s且配准精度更佳.
3.2.5 MDRC中不同膨胀率的影响
MDRC中使用膨胀卷积提取多尺度上下文信息,考虑到膨胀率会影响模型提取特征的能力,因此设置了三组对比实验来测试不同膨胀率对配准性能的影响.第一组在浅层网络就扩大膨胀率,第二组在第三层编码器中连续使用较大膨胀率,第三组在网络最深层使用更大的膨胀率.结果如表5 所示,浅层就扩大膨胀率,其DSC较本文模型提高了0.27%,但HD95增大至2.148 mm且非正雅可比行列式百分比显著增大,说明过早扩大感受野可能会模糊局部细节,破坏变形场的连续性.中高层连续使用相同的膨胀率,导致特征变得稀疏,产生明显网格效应,配准精度下降.在深层网络使用更大的膨胀率,感受野虽然变大但特征点更加稀疏,可能会引入无关区域的噪声导致DSC、HD95和非正雅可比行列式百分比指标变差.综合多个指标,将膨胀率设置为1, 1, 1, 2, 2时达到最优的权衡,在浅层保证边缘、局部解剖结构的对齐,中高层通过逐步扩大膨胀率以保证空间连续性,深层不引入过大膨胀率避免产生大量空洞.
4 结论
本文提出了一种无监督可变形配准网络MDDA-Net,该网络通过设计多尺度膨胀残差卷积模块实现多尺度特征感知,在不同层编码器中捕获局部细节和更大范围的上下文信息.同时,设计通道-空间双重注意力,通过自适应通道注意力和分组空间注意力同时捕获通道和空间特征信息,提高网络对关键特征的表达能力.另外还引入动态上采样,改善传统上采样操作因固定采样导致几何结构失真的问题.利用本文提出的网络在IXI和LPBA40两个三维脑部数据集上实验并与主流的配准方法进行比较,多个评价指标的结果表明,MDDA-Net具有先进的配准性能,此外,设计消融实验验证了本文提出模块的有效性.本研究还存在一些不足之处:首先,本文仅聚焦于脑部数据集的配准,未来可以探索与分割或分类等任务结合,进一步提升模型在脑部疾病检测诊断方面的性能.其次,本文基于单模态图像设计模型,但在临床应用中,通常需要对CT-MRI等不同模态进行配准,后续考虑将研究拓展至多模态配准任务中.最后,虽然MDRC有效扩大了感受野并引入了多尺度上下文信息,但对于全局信息建模能力较弱,若使用更大的膨胀率来提取全局信息,会引入网格效应导致信息丢失,未来考虑构建全局模块以增强网络对长距离依赖的建模.
附件材料附录
利益冲突
参考文献
View Option
[1]
ZHU H Y LI M JI Y L et al . A body examination study of brain MRI registration in adolescents using fusion generative adversarial network
[J]. Chinese J Magn Reson Imaging , 2023 , 14 (2 ): 116 -124 .
[本文引用: 1]
朱海艳 , 李盟 , 季跃龙 , 等 . 融合生成对抗网络的青少年脑MRI配准体测研究
[J]. 磁共振成像 , 2023 , 14 (2 ): 116 -124 .
[本文引用: 1]
[2]
ZHOU Q WANG Y J Groupwise registration for magnetic resonance image based on variational inference
[J]. Chinese J Magn Reson , 2022 , 39 (3 ): 291 -302 .
[本文引用: 1]
周勤 , 王远军 . 基于变分推断的磁共振图像群组配准
[J]. 波谱学杂志 , 2022 , 39 (3 ): 291 -302 .
DOI:10.11938/cjmr20212918
[本文引用: 1]
为解决基于深度学习的成对配准方法精度低和传统配准算法耗时长的问题,本文提出一种基于变分推断的无监督端到端的群组配准以及基于局部归一化互相关(NCC)和先验的配准框架,该框架能够将多个图像配准到公共空间并有效地控制变形场的正则化,且不需要真实的变形场和参考图像.该方法得到的预估变形场可建模为概率生成模型,使用变分推断的方法求解;然后借助空间转换网络和损失函数来实现无监督方式训练.对于公开数据集LPBA40的3D脑磁共振图像配准任务,测试结果表明:本文所提出的方法与基线方法相比,具有较好的Dice得分、运行时间少且产生更好的微分同胚域,同时对噪声具有鲁棒性.
[3]
BAN Y WANG Y LIU S et al . 2D/3D multimode medical image alignment based on spatial histograms
[J]. Appl Sci , 2022 , 12 (16 ): 8261 .
DOI:10.3390/app12168261
URL
[本文引用: 1]
The key to image-guided surgery (IGS) technology is to find the transformation relationship between preoperative 3D images and intraoperative 2D images, namely, 2D/3D image registration. A feature-based 2D/3D medical image registration algorithm is investigated in this study. We use a two-dimensional weighted spatial histogram of gradient directions to extract statistical features, overcome the algorithm’s limitations, and expand the applicable scenarios under the premise of ensuring accuracy. The proposed algorithm was tested on CT and synthetic X-ray images, and compared with existing algorithms. The results show that the proposed algorithm can improve accuracy and efficiency, and reduce the initial value’s sensitivity.
[4]
BOSMA L S ZACHIU C SENNEVILLE B D D et al . Intensity-based quality assurance criteria for deformable image registration in image-guided radiotherapy
[J]. Med Phys , 2023 , 50 (9 ): 5715 -5722 .
DOI:10.1002/mp.v50.9
URL
[本文引用: 1]
[5]
XUE P DONG E JI H Lung 4D CT image registration based on high-order markov random field
[J]. IEEE Trans Med Imaging , 2019 , 39 (4 ): 910 -921 .
DOI:10.1109/TMI.42
URL
[本文引用: 1]
[6]
MANERA A L DADAR M FONOV V et al . CerebrA, registration and manual label correction of Mindboggle-101 atlas for MNI-ICBM152 template
[J]. Sci Data , 2020 , 7 (1 ): 237 .
DOI:10.1038/s41597-020-0557-9
PMID:32669554
[本文引用: 1]
Accurate anatomical atlases are recognized as important tools in brain-imaging research. They are widely used to estimate disease-specific changes and therefore, are of great relevance in extracting regional information on volumetric variations in clinical cohorts in comparison to healthy populations. The use of high spatial resolution magnetic resonance imaging and the improvement in data preprocessing methods have enabled the study of structural volume changes on a wide range of disorders, particularly in neurodegenerative diseases where different brain morphometry analyses are being broadly used in an effort to improve diagnostic biomarkers. In the present dataset, we introduce the Cerebrum Atlas (CerebrA) along with the MNI-ICBM2009c average template. MNI-ICBM2009c is the most recent version of the MNI-ICBM152 brain average, providing a higher level of anatomical details. Cerebra is based on an accurate non-linear registration of cortical and subcortical labelling from Mindboggle 101 to the symmetric MNI-ICBM2009c atlas, followed by manual editing.
[7]
BALAKRISHNAN G ZHAO A SABUNCU M R et al . Voxelmorph: a learning framework for deformable medical image registration
[J]. IEEE Trans Med Imaging , 2019 , 38 (8 ): 1788 -1800 .
DOI:10.1109/TMI.42
URL
[本文引用: 7]
[8]
CHEN X WANG X ZHANG K et al . Recent advances and clinical applications of deep learning in medical image analysis
[J]. Med Image Anal , 2022 , 79 : 102444 .
DOI:10.1016/j.media.2022.102444
URL
[本文引用: 1]
[9]
JADERBERG M SIMONYAN K ZISSERMAN A Spatial transformer networks
[J]. Adv Neural Inf Process Syst , 2015 , 28 : 2017 -2025 .
[本文引用: 1]
[11]
MOK T C W CHUNG A Fast symmetric diffeomorphic image registration with convolutional neural networks
[C]// Proceedings of the IEEE/CVF International Conference on Computer Vision . Seattle, WA, USA : IEEE , 2020 : 4644 -4653 .
[本文引用: 1]
[12]
VASWANI A SHAZEER N PARMAR N et al . Attention is all you need
[C]// Advances in Neural Information Processing Systems 30 . Long Beach, CA, USA : Curran Associates , 2017 : 5998 -6008 .
[本文引用: 1]
[13]
DOSOVITSKIY A BEYER L KOLESNIKOV A et al . An image is worth 16×16 words:Transformers for image recognition at scale[PP/OL]
arXiv (2021-06-03 )[2025-11-25 ]. https://arxiv.org/abs/2010.11929.
URL
[本文引用: 1]
[14]
CHEN J HE Y FREY E C et al . Vit-V-Net: Vision transformer for unsupervised volumetric medical image registration [PP/OL]. arXiv 2021-04-13 )[2025-11-25 ]. https://arxiv.org/abs/2104.06468.
URL
[本文引用: 3]
[16]
LIU Z LIN Y CAO Y et al . Swin transformer: Hierarchical vision transformer using shifted windows
[C]// Proceedings of the IEEE/CVF International Conference on Computer Vision . Montreal, QC, Canada : IEEE , 2021 : 10012 -10022 .
[本文引用: 1]
[17]
SHI J HE Y KONG Y et al . Xmorpher: Full transformer for deformable medical image registration via cross attention
[C]// International Conference on Medical Image Computing and Computer-Assisted Intervention . Singapore : Springer , 2022 : 217 -226 .
[本文引用: 1]
[18]
ZHENG J Q WANG Z HUANG B et al . Recursive deformable image registration network with mutual attention
[C]// Annual Conference on Medical Image Understanding and Analysis . Cambridge, UK : Springer , 2022 : 75 -86 .
[本文引用: 1]
[19]
WANG H NI D WANG Y Modet: Learning deformable image registration via motion decomposition transformer
[C]// International Conference on Medical Image Computing and Computer-Assisted Intervention . Vancouver, BC, Canada : Springer , 2023 : 740 -749 .
[本文引用: 1]
[20]
CHEN Z ZHENG Y GEE J C Transmatch: A transformer-based multilevel dual-stream feature matching network for unsupervised deformable image registration
[J]. IEEE Trans Med Imaging , 2023 , 43 (1 ): 15 -27 .
DOI:10.1109/TMI.2023.3288136
URL
[本文引用: 1]
[21]
LIU Z MAO H WU C Y et al . A convnet for the 2020s
[C]// Proceedings of the IEEE/CVF conference on computer vision and pattern recognition . New Orleans, LA, USA : IEEE , 2022 : 11976 -11986 .
[本文引用: 2]
[22]
CHOLLET F Xception: Deep learning with depthwise separable convolutions
[C]// Proceedings of the IEEE conference on computer vision and pattern recognition. Honolulu, HI, USA : IEEE , 2017 : 1251 -1258 .
[本文引用: 1]
[23]
LIU W LU H FU H et al . Learning to upsample by learning to sample
[C]// Proceedings of the IEEE/CVF international conference on computer vision . Paris, France : IEEE , 2023 : 6027 -6037 .
[本文引用: 2]
[24]
WANG J CHEN K XU R et al . Carafe: Content-aware reassembly of features
[C]// Proceedings of the IEEE/CVF international conference on computer vision . Seoul, Korea : IEEE , 2019 : 3007 -3016 .
[本文引用: 1]
[25]
LU H LIU W FU H et al . FADE: Fusing the assets of decoder and encoder for task-agnostic upsampling
[C]// European conference on computer vision . Tel Aviv, Israel : Springer , 2022 : 231 -247 .
[本文引用: 1]
[26]
RAO Y R PRATHAPANI N NAGABHOOSHANAM E Application of normalized cross correlation to image registration
[J]. Int J Res Eng Technol , 2014 , 3 (5 ): 12 -16 .
[本文引用: 1]
[27]
FISCHL B FreeSurfer
[J]. NeuroImage , 2012 , 62 (2 ): 774 -781 .
DOI:10.1016/j.neuroimage.2012.01.021
PMID:22248573
[本文引用: 1]
FreeSurfer is a suite of tools for the analysis of neuroimaging data that provides an array of algorithms to quantify the functional, connectional and structural properties of the human brain. It has evolved from a package primarily aimed at generating surface representations of the cerebral cortex into one that automatically creates models of most macroscopically visible structures in the human brain given any reasonable T1-weighted input image. It is freely available, runs on a wide variety of hardware and software platforms, and is open source.Copyright © 2012 Elsevier Inc. All rights reserved.
[28]
SHATTUCK D W MIRZA M ADISETIYO V et al . Construction of a 3D probabilistic atlas of human cortical structures
[J]. NeuroImage , 2008 , 39 (3 ): 1064 -1080 .
DOI:10.1016/j.neuroimage.2007.09.031
PMID:18037310
[本文引用: 1]
We describe the construction of a digital brain atlas composed of data from manually delineated MRI data. A total of 56 structures were labeled in MRI of 40 healthy, normal volunteers. This labeling was performed according to a set of protocols developed for this project. Pairs of raters were assigned to each structure and trained on the protocol for that structure. Each rater pair was tested for concordance on 6 of the 40 brains; once they had achieved reliability standards, they divided the task of delineating the remaining 34 brains. The data were then spatially normalized to well-known templates using 3 popular algorithms: AIR5.2.5's nonlinear warp (Woods et al., 1998) paired with the ICBM452 Warp 5 atlas (Rex et al., 2003), FSL's FLIRT (Smith et al., 2004) was paired with its own template, a skull-stripped version of the ICBM152 T1 average; and SPM5's unified segmentation method (Ashburner and Friston, 2005) was paired with its canonical brain, the whole head ICBM152 T1 average. We thus produced 3 variants of our atlas, where each was constructed from 40 representative samples of a data processing stream that one might use for analysis. For each normalization algorithm, the individual structure delineations were then resampled according to the computed transformations. We next computed averages at each voxel location to estimate the probability of that voxel belonging to each of the 56 structures. Each version of the atlas contains, for every voxel, probability densities for each region, thus providing a resource for automated probabilistic labeling of external data types registered into standard spaces; we also computed average intensity images and tissue density maps based on the three methods and target spaces. These atlases will serve as a resource for diverse applications including meta-analysis of functional and structural imaging data and other bioinformatics applications where display of arbitrary labels in probabilistically defined anatomic space will facilitate both knowledge-based development and visualization of findings from multiple disciplines.
[29]
AVANTS B B EPSTEIN C L GROSSMAN M et al . Symmetric diffeomorphic image registration with cross-correlation: evaluating automated labeling of elderly and neurodegenerative brain
[J]. Med Image Anal , 2008 , 12 (1 ): 26 -41 .
DOI:10.1016/j.media.2007.06.004
PMID:17659998
[本文引用: 2]
One of the most challenging problems in modern neuroimaging is detailed characterization of neurodegeneration. Quantifying spatial and longitudinal atrophy patterns is an important component of this process. These spatiotemporal signals will aid in discriminating between related diseases, such as frontotemporal dementia (FTD) and Alzheimer's disease (AD), which manifest themselves in the same at-risk population. Here, we develop a novel symmetric image normalization method (SyN) for maximizing the cross-correlation within the space of diffeomorphic maps and provide the Euler-Lagrange equations necessary for this optimization. We then turn to a careful evaluation of our method. Our evaluation uses gold standard, human cortical segmentation to contrast SyN's performance with a related elastic method and with the standard ITK implementation of Thirion's Demons algorithm. The new method compares favorably with both approaches, in particular when the distance between the template brain and the target brain is large. We then report the correlation of volumes gained by algorithmic cortical labelings of FTD and control subjects with those gained by the manual rater. This comparison shows that, of the three methods tested, SyN's volume measurements are the most strongly correlated with volume measurements gained by expert labeling. This study indicates that SyN, with cross-correlation, is a reliable method for normalizing and making anatomical measurements in volumetric MRI of patients and at-risk elderly individuals.
[30]
MODAT M RIDGWAY G R TAYLOR Z A et al . Fast free-form deformation using graphics processing units
[J]. Comput Meth Prog Bio , 2010 , 98 (3 ): 278 -284 .
DOI:10.1016/j.cmpb.2009.09.002
PMID:19818524
[本文引用: 2]
A large number of algorithms have been developed to perform non-rigid registration and it is a tool commonly used in medical image analysis. The free-form deformation algorithm is a well-established technique, but is extremely time consuming. In this paper we present a parallel-friendly formulation of the algorithm suitable for graphics processing unit execution. Using our approach we perform registration of T1-weighted MR images in less than 1 min and show the same level of accuracy as a classical serial implementation when performing segmentation propagation. This technology could be of significant utility in time-critical applications such as image-guided interventions, or in the processing of large data sets.Copyright 2009 Elsevier Ireland Ltd. All rights reserved.
[31]
DICE L R Measures of the amount of ecologic association between species
[J]. Ecology , 1945 , 26 (3 ): 297 -302 .
DOI:10.2307/1932409
URL
[本文引用: 1]
[32]
TAHA A A HANBURY A An efficient algorithm for calculating the exact Hausdorff distance
[J]. IEEE Trans Pattern Anal Mach Intell , 2015 , 37 (11 ): 2153 -2163 .
DOI:10.1109/TPAMI.2015.2408351
URL
[本文引用: 1]
[33]
CHEN L C ZHU Y PAPANDREOU G et al . Encoder-decoder with atrous separable convolution for semantic image segmentation
[C]// Proceedings of the European conference on computer vision . Munich, Germany : Springer , 2018 : 801 -818 .
[本文引用: 1]
[34]
WOO S PARK J LEE J Y et al . CBAM: Convolutional block attention module
[C]// Proceedings of the European conference on computer vision . Munich, Germany : Springer , 2018 : 3 -19 .
[本文引用: 1]
[35]
HU J SHEN L SUN G Squeeze-and-excitation networks
[C]// Proceedings of the IEEE conference on computer vision and pattern recognition . Salt Lake City, UT, USA : IEEE , 2018 : 7132 -7141 .
[本文引用: 1]
A body examination study of brain MRI registration in adolescents using fusion generative adversarial network
1
2023
... 可变形配准(Deformable Image Registration,DIR)作为医学影像分析任务的基础,在疾病诊断[1 ,2 ] 、手术导航[3 ] 、放射治疗[4 ] 、运动建模[5 ] 和图谱分析[6 ] 等领域应用广泛.它通过建立两幅图像间的非线性空间对应关系,将图像转换到一个共同坐标系下,实现图像间的对齐.传统配准方法依赖显式特征建立不同图像的几何关联,这些特征通常是人为设计.另外,传统方法对于每一对新输入的图像都需要重新求解,导致优化过程耗时且易陷入局部最优解. ...
融合生成对抗网络的青少年脑MRI配准体测研究
1
2023
... 可变形配准(Deformable Image Registration,DIR)作为医学影像分析任务的基础,在疾病诊断[1 ,2 ] 、手术导航[3 ] 、放射治疗[4 ] 、运动建模[5 ] 和图谱分析[6 ] 等领域应用广泛.它通过建立两幅图像间的非线性空间对应关系,将图像转换到一个共同坐标系下,实现图像间的对齐.传统配准方法依赖显式特征建立不同图像的几何关联,这些特征通常是人为设计.另外,传统方法对于每一对新输入的图像都需要重新求解,导致优化过程耗时且易陷入局部最优解. ...
Groupwise registration for magnetic resonance image based on variational inference
1
2022
... 可变形配准(Deformable Image Registration,DIR)作为医学影像分析任务的基础,在疾病诊断[1 ,2 ] 、手术导航[3 ] 、放射治疗[4 ] 、运动建模[5 ] 和图谱分析[6 ] 等领域应用广泛.它通过建立两幅图像间的非线性空间对应关系,将图像转换到一个共同坐标系下,实现图像间的对齐.传统配准方法依赖显式特征建立不同图像的几何关联,这些特征通常是人为设计.另外,传统方法对于每一对新输入的图像都需要重新求解,导致优化过程耗时且易陷入局部最优解. ...
基于变分推断的磁共振图像群组配准
1
2022
... 可变形配准(Deformable Image Registration,DIR)作为医学影像分析任务的基础,在疾病诊断[1 ,2 ] 、手术导航[3 ] 、放射治疗[4 ] 、运动建模[5 ] 和图谱分析[6 ] 等领域应用广泛.它通过建立两幅图像间的非线性空间对应关系,将图像转换到一个共同坐标系下,实现图像间的对齐.传统配准方法依赖显式特征建立不同图像的几何关联,这些特征通常是人为设计.另外,传统方法对于每一对新输入的图像都需要重新求解,导致优化过程耗时且易陷入局部最优解. ...
2D/3D multimode medical image alignment based on spatial histograms
1
2022
... 可变形配准(Deformable Image Registration,DIR)作为医学影像分析任务的基础,在疾病诊断[1 ,2 ] 、手术导航[3 ] 、放射治疗[4 ] 、运动建模[5 ] 和图谱分析[6 ] 等领域应用广泛.它通过建立两幅图像间的非线性空间对应关系,将图像转换到一个共同坐标系下,实现图像间的对齐.传统配准方法依赖显式特征建立不同图像的几何关联,这些特征通常是人为设计.另外,传统方法对于每一对新输入的图像都需要重新求解,导致优化过程耗时且易陷入局部最优解. ...
Intensity-based quality assurance criteria for deformable image registration in image-guided radiotherapy
1
2023
... 可变形配准(Deformable Image Registration,DIR)作为医学影像分析任务的基础,在疾病诊断[1 ,2 ] 、手术导航[3 ] 、放射治疗[4 ] 、运动建模[5 ] 和图谱分析[6 ] 等领域应用广泛.它通过建立两幅图像间的非线性空间对应关系,将图像转换到一个共同坐标系下,实现图像间的对齐.传统配准方法依赖显式特征建立不同图像的几何关联,这些特征通常是人为设计.另外,传统方法对于每一对新输入的图像都需要重新求解,导致优化过程耗时且易陷入局部最优解. ...
Lung 4D CT image registration based on high-order markov random field
1
2019
... 可变形配准(Deformable Image Registration,DIR)作为医学影像分析任务的基础,在疾病诊断[1 ,2 ] 、手术导航[3 ] 、放射治疗[4 ] 、运动建模[5 ] 和图谱分析[6 ] 等领域应用广泛.它通过建立两幅图像间的非线性空间对应关系,将图像转换到一个共同坐标系下,实现图像间的对齐.传统配准方法依赖显式特征建立不同图像的几何关联,这些特征通常是人为设计.另外,传统方法对于每一对新输入的图像都需要重新求解,导致优化过程耗时且易陷入局部最优解. ...
CerebrA, registration and manual label correction of Mindboggle-101 atlas for MNI-ICBM152 template
1
2020
... 可变形配准(Deformable Image Registration,DIR)作为医学影像分析任务的基础,在疾病诊断[1 ,2 ] 、手术导航[3 ] 、放射治疗[4 ] 、运动建模[5 ] 和图谱分析[6 ] 等领域应用广泛.它通过建立两幅图像间的非线性空间对应关系,将图像转换到一个共同坐标系下,实现图像间的对齐.传统配准方法依赖显式特征建立不同图像的几何关联,这些特征通常是人为设计.另外,传统方法对于每一对新输入的图像都需要重新求解,导致优化过程耗时且易陷入局部最优解. ...
Voxelmorph: a learning framework for deformable medical image registration
7
2019
... 随着深度学习技术在图像分割、图像重建等众多计算机视觉任务中展现出优越的性能,一些研究学者将其引入医学图像配准中[7 ] .根据训练方式的不同,基于深度学习的配准可分为半监督配准、全监督配准和无监督配准三种[8 ] .前两类方法需要真实的变形场作为标签数据,而这些数据通常由传统算法生成或人工标注,获取成本高且存在一定误差.而无监督配准模型训练时无需真实的变形场,避免了对标签数据的依赖,只需要提供一对图像就可以预测变形场.因此,基于无监督学习的配准方法受到了广泛关注. Balakrishnan等人[7 ] 设计了一个无监督配准通用模型VoxelMorph,该模型分为U-Net网络和空间变换网络(Spatial Transformer Networks,STN)[9 ] 两部分,U-Net负责生成变形场,STN则根据变形场对运动图像进行变形得到配准后的图像.CycleMorph[10 ] 是一种循环一致可变形配准方法,该方法训练了两个卷积神经网络(Convolutional Neural Networks,CNN),分别生成正向和反向变形场,并引入循环一致性损失以保证图像的拓扑结构.Mok等人[11 ] 提出一个基于CNN的对称微分同胚配准模型SYMNet,该方法通过一个中间变形场估计两幅图像间正向和反向变换,保证变换的可逆性和拓扑结构.以上方法基于CNN实现,它们使用固定大小的卷积核,有限的感受野只能提取局部的信息,对远距离空间的建模能力存在局限性. ...
... [7 ]设计了一个无监督配准通用模型VoxelMorph,该模型分为U-Net网络和空间变换网络(Spatial Transformer Networks,STN)[9 ] 两部分,U-Net负责生成变形场,STN则根据变形场对运动图像进行变形得到配准后的图像.CycleMorph[10 ] 是一种循环一致可变形配准方法,该方法训练了两个卷积神经网络(Convolutional Neural Networks,CNN),分别生成正向和反向变形场,并引入循环一致性损失以保证图像的拓扑结构.Mok等人[11 ] 提出一个基于CNN的对称微分同胚配准模型SYMNet,该方法通过一个中间变形场估计两幅图像间正向和反向变换,保证变换的可逆性和拓扑结构.以上方法基于CNN实现,它们使用固定大小的卷积核,有限的感受野只能提取局部的信息,对远距离空间的建模能力存在局限性. ...
... 现有经典配准方法如VoxelMorph[7 ] 、CycleMorph[10 ] 等在编码器阶段均使用标准卷积提取特征,但标准卷积受限于固定的感受野,难以有效捕捉脑部图像复杂的局部形变信息,导致大变形解剖区域配准效果不佳.因此,本研究设计了多尺度膨胀残差卷积模块(Multi-Dilated Residual Convolution Module,MDRC),充分扩大卷积的感受野以捕获更多的上下文信息,提升网络捕获变形的能力. ...
... 优化相似性损失函数可以使配准后图像最大程度和固定图像相似,但得到的变形场不一定是光滑的,因此,在变形场的空间梯度上使用扩散正则化保证合理的变形.本文选用L2范数[7 ] 来约束变形场的平滑性: ...
... 本实验选择了传统配准SyN[29 ] 、NiftyReg[30 ] 以及深度学习经典算法VoxelMorph[7 ] 、CycleMorph[10 ] 、Vit-V-Net[14 ] 、TransMorph[15 ] 作为对比方法,所有模型均在配备NVIDIA RTX3090(24G)显卡的PC上使用PyTorch框架实现,使用Adam优化算法,IXI数据集训练500 epochs,LPBA40数据集训练1 000 epochs.两个数据集的学习率设置为1×10⁻⁴ ,batchsize为1.在训练过程中,对脑部MRI数据集进行数据随机翻转,实现数据增强.训练超参数的设置详见附录表A2 . ...
... 在两个不同的数据集上进行基于图谱的配准,将本文提出的模型与SyN[29 ] 、NiftyReg[30 ] 、VoxelMorph-1[7 ] 、VoxelMorph-2[7 ] 、CycleMorph[10 ] 、Vit-V-Net[14 ] 及TransMorph[15 ] 比较并进行定量和定性分析.其中,SyN和NiftyReg为基于迭代优化的经典传统配准算法,VoxelMorph-1、VoxelMorph-2以及CycleMorph是基于CNN的深度学习配准方法,Vit-V-Net和TransMorph是基于Transformer的深度学习配准方法.表1 和表2 是不同配准模型在IXI数据集和LPBA40数据集上的定量结果,粗体表示最优结果. ...
... [7 ]、CycleMorph[10 ] 、Vit-V-Net[14 ] 及TransMorph[15 ] 比较并进行定量和定性分析.其中,SyN和NiftyReg为基于迭代优化的经典传统配准算法,VoxelMorph-1、VoxelMorph-2以及CycleMorph是基于CNN的深度学习配准方法,Vit-V-Net和TransMorph是基于Transformer的深度学习配准方法.表1 和表2 是不同配准模型在IXI数据集和LPBA40数据集上的定量结果,粗体表示最优结果. ...
Recent advances and clinical applications of deep learning in medical image analysis
1
2022
... 随着深度学习技术在图像分割、图像重建等众多计算机视觉任务中展现出优越的性能,一些研究学者将其引入医学图像配准中[7 ] .根据训练方式的不同,基于深度学习的配准可分为半监督配准、全监督配准和无监督配准三种[8 ] .前两类方法需要真实的变形场作为标签数据,而这些数据通常由传统算法生成或人工标注,获取成本高且存在一定误差.而无监督配准模型训练时无需真实的变形场,避免了对标签数据的依赖,只需要提供一对图像就可以预测变形场.因此,基于无监督学习的配准方法受到了广泛关注. Balakrishnan等人[7 ] 设计了一个无监督配准通用模型VoxelMorph,该模型分为U-Net网络和空间变换网络(Spatial Transformer Networks,STN)[9 ] 两部分,U-Net负责生成变形场,STN则根据变形场对运动图像进行变形得到配准后的图像.CycleMorph[10 ] 是一种循环一致可变形配准方法,该方法训练了两个卷积神经网络(Convolutional Neural Networks,CNN),分别生成正向和反向变形场,并引入循环一致性损失以保证图像的拓扑结构.Mok等人[11 ] 提出一个基于CNN的对称微分同胚配准模型SYMNet,该方法通过一个中间变形场估计两幅图像间正向和反向变换,保证变换的可逆性和拓扑结构.以上方法基于CNN实现,它们使用固定大小的卷积核,有限的感受野只能提取局部的信息,对远距离空间的建模能力存在局限性. ...
Spatial transformer networks
1
2015
... 随着深度学习技术在图像分割、图像重建等众多计算机视觉任务中展现出优越的性能,一些研究学者将其引入医学图像配准中[7 ] .根据训练方式的不同,基于深度学习的配准可分为半监督配准、全监督配准和无监督配准三种[8 ] .前两类方法需要真实的变形场作为标签数据,而这些数据通常由传统算法生成或人工标注,获取成本高且存在一定误差.而无监督配准模型训练时无需真实的变形场,避免了对标签数据的依赖,只需要提供一对图像就可以预测变形场.因此,基于无监督学习的配准方法受到了广泛关注. Balakrishnan等人[7 ] 设计了一个无监督配准通用模型VoxelMorph,该模型分为U-Net网络和空间变换网络(Spatial Transformer Networks,STN)[9 ] 两部分,U-Net负责生成变形场,STN则根据变形场对运动图像进行变形得到配准后的图像.CycleMorph[10 ] 是一种循环一致可变形配准方法,该方法训练了两个卷积神经网络(Convolutional Neural Networks,CNN),分别生成正向和反向变形场,并引入循环一致性损失以保证图像的拓扑结构.Mok等人[11 ] 提出一个基于CNN的对称微分同胚配准模型SYMNet,该方法通过一个中间变形场估计两幅图像间正向和反向变换,保证变换的可逆性和拓扑结构.以上方法基于CNN实现,它们使用固定大小的卷积核,有限的感受野只能提取局部的信息,对远距离空间的建模能力存在局限性. ...
CycleMorph: cycle consistent unsupervised deformable image registration
5
2021
... 随着深度学习技术在图像分割、图像重建等众多计算机视觉任务中展现出优越的性能,一些研究学者将其引入医学图像配准中[7 ] .根据训练方式的不同,基于深度学习的配准可分为半监督配准、全监督配准和无监督配准三种[8 ] .前两类方法需要真实的变形场作为标签数据,而这些数据通常由传统算法生成或人工标注,获取成本高且存在一定误差.而无监督配准模型训练时无需真实的变形场,避免了对标签数据的依赖,只需要提供一对图像就可以预测变形场.因此,基于无监督学习的配准方法受到了广泛关注. Balakrishnan等人[7 ] 设计了一个无监督配准通用模型VoxelMorph,该模型分为U-Net网络和空间变换网络(Spatial Transformer Networks,STN)[9 ] 两部分,U-Net负责生成变形场,STN则根据变形场对运动图像进行变形得到配准后的图像.CycleMorph[10 ] 是一种循环一致可变形配准方法,该方法训练了两个卷积神经网络(Convolutional Neural Networks,CNN),分别生成正向和反向变形场,并引入循环一致性损失以保证图像的拓扑结构.Mok等人[11 ] 提出一个基于CNN的对称微分同胚配准模型SYMNet,该方法通过一个中间变形场估计两幅图像间正向和反向变换,保证变换的可逆性和拓扑结构.以上方法基于CNN实现,它们使用固定大小的卷积核,有限的感受野只能提取局部的信息,对远距离空间的建模能力存在局限性. ...
... 现有经典配准方法如VoxelMorph[7 ] 、CycleMorph[10 ] 等在编码器阶段均使用标准卷积提取特征,但标准卷积受限于固定的感受野,难以有效捕捉脑部图像复杂的局部形变信息,导致大变形解剖区域配准效果不佳.因此,本研究设计了多尺度膨胀残差卷积模块(Multi-Dilated Residual Convolution Module,MDRC),充分扩大卷积的感受野以捕获更多的上下文信息,提升网络捕获变形的能力. ...
... IXI(Information eXtraction from Images)数据集[15 ] 共包含576张T 1 加权脑部MR图像,按照7 : 1 : 2的比例划分为训练集、验证集和测试集,即分别使用403、58和115张图像进行训练、验证和测试.对于IXI数据集,本文进行了基于图谱的配准,选择Kim等人[10 ] 提供的脑图谱MRI作为运动图像.所有扫描图像均使用FreeSurfer[27 ] 进行预处理,包括颅骨剥离、重采样、仿射对齐及裁剪和归一化等步骤,所有图像尺寸裁剪为160×192×224,并使用专家标注的30个感兴趣区域(region of interest,ROI)的标签图来评估配准算法的性能. ...
... 本实验选择了传统配准SyN[29 ] 、NiftyReg[30 ] 以及深度学习经典算法VoxelMorph[7 ] 、CycleMorph[10 ] 、Vit-V-Net[14 ] 、TransMorph[15 ] 作为对比方法,所有模型均在配备NVIDIA RTX3090(24G)显卡的PC上使用PyTorch框架实现,使用Adam优化算法,IXI数据集训练500 epochs,LPBA40数据集训练1 000 epochs.两个数据集的学习率设置为1×10⁻⁴ ,batchsize为1.在训练过程中,对脑部MRI数据集进行数据随机翻转,实现数据增强.训练超参数的设置详见附录表A2 . ...
... 在两个不同的数据集上进行基于图谱的配准,将本文提出的模型与SyN[29 ] 、NiftyReg[30 ] 、VoxelMorph-1[7 ] 、VoxelMorph-2[7 ] 、CycleMorph[10 ] 、Vit-V-Net[14 ] 及TransMorph[15 ] 比较并进行定量和定性分析.其中,SyN和NiftyReg为基于迭代优化的经典传统配准算法,VoxelMorph-1、VoxelMorph-2以及CycleMorph是基于CNN的深度学习配准方法,Vit-V-Net和TransMorph是基于Transformer的深度学习配准方法.表1 和表2 是不同配准模型在IXI数据集和LPBA40数据集上的定量结果,粗体表示最优结果. ...
Fast symmetric diffeomorphic image registration with convolutional neural networks
1
2020
... 随着深度学习技术在图像分割、图像重建等众多计算机视觉任务中展现出优越的性能,一些研究学者将其引入医学图像配准中[7 ] .根据训练方式的不同,基于深度学习的配准可分为半监督配准、全监督配准和无监督配准三种[8 ] .前两类方法需要真实的变形场作为标签数据,而这些数据通常由传统算法生成或人工标注,获取成本高且存在一定误差.而无监督配准模型训练时无需真实的变形场,避免了对标签数据的依赖,只需要提供一对图像就可以预测变形场.因此,基于无监督学习的配准方法受到了广泛关注. Balakrishnan等人[7 ] 设计了一个无监督配准通用模型VoxelMorph,该模型分为U-Net网络和空间变换网络(Spatial Transformer Networks,STN)[9 ] 两部分,U-Net负责生成变形场,STN则根据变形场对运动图像进行变形得到配准后的图像.CycleMorph[10 ] 是一种循环一致可变形配准方法,该方法训练了两个卷积神经网络(Convolutional Neural Networks,CNN),分别生成正向和反向变形场,并引入循环一致性损失以保证图像的拓扑结构.Mok等人[11 ] 提出一个基于CNN的对称微分同胚配准模型SYMNet,该方法通过一个中间变形场估计两幅图像间正向和反向变换,保证变换的可逆性和拓扑结构.以上方法基于CNN实现,它们使用固定大小的卷积核,有限的感受野只能提取局部的信息,对远距离空间的建模能力存在局限性. ...
Attention is all you need
1
2017
... 近年来,学者们在网络中引入Transformer架构[12 ] 以建模远距离空间依赖关系.Transformer架构将输入图像分成多个patch,利用自注意力机制,通过查询(Query)、键(Key)和值(Value)矩阵计算每个patch与其他patch的相关性,使得该patch获得全局信息.Dosovitskiy等人[13 ] 受其启发于2020年提出了Vision Transformer(ViT)模型,ViT模型将输入图像划分为固定大小的patch并映射为token,对于每个token给予一个可学习的位置编码和class token,然后传入Transformer模块并通过多层感知机头(Multilayer Perceptron Head,MLP Head)得到最终结果.Chen等人[14 ] 将CNN和ViT模型结合设计了CNN-Transformer混合架构的模型Vit-V-Net,进一步提高了配准精度.在此基础上,Chen等人[15 ] 进一步提出TransMorph模型,编码器使用Swin Transformer[16 ] ,利用窗口注意力替代ViT模型的全局注意力,并且不需要额外的位置编码,降低参数量的同时提升了配准性能.后续的一些方法基于Transformer架构进行改进.Shi等人[17 ] 提出一种纯Transformer架构网络XMorpher,设计两个并行的特征提取网络分别提取固定图像和运动图像的特征,并通过交叉注意力模块建立两幅图像的对应关系,促进特征的高效融合. Zheng等人[18 ] 将互注意力机制和递归网络结合,扩大感受野,对可变形配准进行逐步细化.Wang等人[19 ] 利用多头邻域注意力机制显式分解不同的运动模态,再通过竞争加权模块融合多个变形子场,实现由粗到细的配准.Chen等人[20 ] 设计双流特征提取分支,结合局部窗口自注意力和局部窗口交叉注意力实现图像间特征的显式匹配. ...
An image is worth 16×16 words:Transformers for image recognition at scale[PP/OL]
1
... 近年来,学者们在网络中引入Transformer架构[12 ] 以建模远距离空间依赖关系.Transformer架构将输入图像分成多个patch,利用自注意力机制,通过查询(Query)、键(Key)和值(Value)矩阵计算每个patch与其他patch的相关性,使得该patch获得全局信息.Dosovitskiy等人[13 ] 受其启发于2020年提出了Vision Transformer(ViT)模型,ViT模型将输入图像划分为固定大小的patch并映射为token,对于每个token给予一个可学习的位置编码和class token,然后传入Transformer模块并通过多层感知机头(Multilayer Perceptron Head,MLP Head)得到最终结果.Chen等人[14 ] 将CNN和ViT模型结合设计了CNN-Transformer混合架构的模型Vit-V-Net,进一步提高了配准精度.在此基础上,Chen等人[15 ] 进一步提出TransMorph模型,编码器使用Swin Transformer[16 ] ,利用窗口注意力替代ViT模型的全局注意力,并且不需要额外的位置编码,降低参数量的同时提升了配准性能.后续的一些方法基于Transformer架构进行改进.Shi等人[17 ] 提出一种纯Transformer架构网络XMorpher,设计两个并行的特征提取网络分别提取固定图像和运动图像的特征,并通过交叉注意力模块建立两幅图像的对应关系,促进特征的高效融合. Zheng等人[18 ] 将互注意力机制和递归网络结合,扩大感受野,对可变形配准进行逐步细化.Wang等人[19 ] 利用多头邻域注意力机制显式分解不同的运动模态,再通过竞争加权模块融合多个变形子场,实现由粗到细的配准.Chen等人[20 ] 设计双流特征提取分支,结合局部窗口自注意力和局部窗口交叉注意力实现图像间特征的显式匹配. ...
3
... 近年来,学者们在网络中引入Transformer架构[12 ] 以建模远距离空间依赖关系.Transformer架构将输入图像分成多个patch,利用自注意力机制,通过查询(Query)、键(Key)和值(Value)矩阵计算每个patch与其他patch的相关性,使得该patch获得全局信息.Dosovitskiy等人[13 ] 受其启发于2020年提出了Vision Transformer(ViT)模型,ViT模型将输入图像划分为固定大小的patch并映射为token,对于每个token给予一个可学习的位置编码和class token,然后传入Transformer模块并通过多层感知机头(Multilayer Perceptron Head,MLP Head)得到最终结果.Chen等人[14 ] 将CNN和ViT模型结合设计了CNN-Transformer混合架构的模型Vit-V-Net,进一步提高了配准精度.在此基础上,Chen等人[15 ] 进一步提出TransMorph模型,编码器使用Swin Transformer[16 ] ,利用窗口注意力替代ViT模型的全局注意力,并且不需要额外的位置编码,降低参数量的同时提升了配准性能.后续的一些方法基于Transformer架构进行改进.Shi等人[17 ] 提出一种纯Transformer架构网络XMorpher,设计两个并行的特征提取网络分别提取固定图像和运动图像的特征,并通过交叉注意力模块建立两幅图像的对应关系,促进特征的高效融合. Zheng等人[18 ] 将互注意力机制和递归网络结合,扩大感受野,对可变形配准进行逐步细化.Wang等人[19 ] 利用多头邻域注意力机制显式分解不同的运动模态,再通过竞争加权模块融合多个变形子场,实现由粗到细的配准.Chen等人[20 ] 设计双流特征提取分支,结合局部窗口自注意力和局部窗口交叉注意力实现图像间特征的显式匹配. ...
... 本实验选择了传统配准SyN[29 ] 、NiftyReg[30 ] 以及深度学习经典算法VoxelMorph[7 ] 、CycleMorph[10 ] 、Vit-V-Net[14 ] 、TransMorph[15 ] 作为对比方法,所有模型均在配备NVIDIA RTX3090(24G)显卡的PC上使用PyTorch框架实现,使用Adam优化算法,IXI数据集训练500 epochs,LPBA40数据集训练1 000 epochs.两个数据集的学习率设置为1×10⁻⁴ ,batchsize为1.在训练过程中,对脑部MRI数据集进行数据随机翻转,实现数据增强.训练超参数的设置详见附录表A2 . ...
... 在两个不同的数据集上进行基于图谱的配准,将本文提出的模型与SyN[29 ] 、NiftyReg[30 ] 、VoxelMorph-1[7 ] 、VoxelMorph-2[7 ] 、CycleMorph[10 ] 、Vit-V-Net[14 ] 及TransMorph[15 ] 比较并进行定量和定性分析.其中,SyN和NiftyReg为基于迭代优化的经典传统配准算法,VoxelMorph-1、VoxelMorph-2以及CycleMorph是基于CNN的深度学习配准方法,Vit-V-Net和TransMorph是基于Transformer的深度学习配准方法.表1 和表2 是不同配准模型在IXI数据集和LPBA40数据集上的定量结果,粗体表示最优结果. ...
Transmorph: Transformer for unsupervised medical image registration
4
2022
... 近年来,学者们在网络中引入Transformer架构[12 ] 以建模远距离空间依赖关系.Transformer架构将输入图像分成多个patch,利用自注意力机制,通过查询(Query)、键(Key)和值(Value)矩阵计算每个patch与其他patch的相关性,使得该patch获得全局信息.Dosovitskiy等人[13 ] 受其启发于2020年提出了Vision Transformer(ViT)模型,ViT模型将输入图像划分为固定大小的patch并映射为token,对于每个token给予一个可学习的位置编码和class token,然后传入Transformer模块并通过多层感知机头(Multilayer Perceptron Head,MLP Head)得到最终结果.Chen等人[14 ] 将CNN和ViT模型结合设计了CNN-Transformer混合架构的模型Vit-V-Net,进一步提高了配准精度.在此基础上,Chen等人[15 ] 进一步提出TransMorph模型,编码器使用Swin Transformer[16 ] ,利用窗口注意力替代ViT模型的全局注意力,并且不需要额外的位置编码,降低参数量的同时提升了配准性能.后续的一些方法基于Transformer架构进行改进.Shi等人[17 ] 提出一种纯Transformer架构网络XMorpher,设计两个并行的特征提取网络分别提取固定图像和运动图像的特征,并通过交叉注意力模块建立两幅图像的对应关系,促进特征的高效融合. Zheng等人[18 ] 将互注意力机制和递归网络结合,扩大感受野,对可变形配准进行逐步细化.Wang等人[19 ] 利用多头邻域注意力机制显式分解不同的运动模态,再通过竞争加权模块融合多个变形子场,实现由粗到细的配准.Chen等人[20 ] 设计双流特征提取分支,结合局部窗口自注意力和局部窗口交叉注意力实现图像间特征的显式匹配. ...
... IXI(Information eXtraction from Images)数据集[15 ] 共包含576张T 1 加权脑部MR图像,按照7 : 1 : 2的比例划分为训练集、验证集和测试集,即分别使用403、58和115张图像进行训练、验证和测试.对于IXI数据集,本文进行了基于图谱的配准,选择Kim等人[10 ] 提供的脑图谱MRI作为运动图像.所有扫描图像均使用FreeSurfer[27 ] 进行预处理,包括颅骨剥离、重采样、仿射对齐及裁剪和归一化等步骤,所有图像尺寸裁剪为160×192×224,并使用专家标注的30个感兴趣区域(region of interest,ROI)的标签图来评估配准算法的性能. ...
... 本实验选择了传统配准SyN[29 ] 、NiftyReg[30 ] 以及深度学习经典算法VoxelMorph[7 ] 、CycleMorph[10 ] 、Vit-V-Net[14 ] 、TransMorph[15 ] 作为对比方法,所有模型均在配备NVIDIA RTX3090(24G)显卡的PC上使用PyTorch框架实现,使用Adam优化算法,IXI数据集训练500 epochs,LPBA40数据集训练1 000 epochs.两个数据集的学习率设置为1×10⁻⁴ ,batchsize为1.在训练过程中,对脑部MRI数据集进行数据随机翻转,实现数据增强.训练超参数的设置详见附录表A2 . ...
... 在两个不同的数据集上进行基于图谱的配准,将本文提出的模型与SyN[29 ] 、NiftyReg[30 ] 、VoxelMorph-1[7 ] 、VoxelMorph-2[7 ] 、CycleMorph[10 ] 、Vit-V-Net[14 ] 及TransMorph[15 ] 比较并进行定量和定性分析.其中,SyN和NiftyReg为基于迭代优化的经典传统配准算法,VoxelMorph-1、VoxelMorph-2以及CycleMorph是基于CNN的深度学习配准方法,Vit-V-Net和TransMorph是基于Transformer的深度学习配准方法.表1 和表2 是不同配准模型在IXI数据集和LPBA40数据集上的定量结果,粗体表示最优结果. ...
Swin transformer: Hierarchical vision transformer using shifted windows
1
2021
... 近年来,学者们在网络中引入Transformer架构[12 ] 以建模远距离空间依赖关系.Transformer架构将输入图像分成多个patch,利用自注意力机制,通过查询(Query)、键(Key)和值(Value)矩阵计算每个patch与其他patch的相关性,使得该patch获得全局信息.Dosovitskiy等人[13 ] 受其启发于2020年提出了Vision Transformer(ViT)模型,ViT模型将输入图像划分为固定大小的patch并映射为token,对于每个token给予一个可学习的位置编码和class token,然后传入Transformer模块并通过多层感知机头(Multilayer Perceptron Head,MLP Head)得到最终结果.Chen等人[14 ] 将CNN和ViT模型结合设计了CNN-Transformer混合架构的模型Vit-V-Net,进一步提高了配准精度.在此基础上,Chen等人[15 ] 进一步提出TransMorph模型,编码器使用Swin Transformer[16 ] ,利用窗口注意力替代ViT模型的全局注意力,并且不需要额外的位置编码,降低参数量的同时提升了配准性能.后续的一些方法基于Transformer架构进行改进.Shi等人[17 ] 提出一种纯Transformer架构网络XMorpher,设计两个并行的特征提取网络分别提取固定图像和运动图像的特征,并通过交叉注意力模块建立两幅图像的对应关系,促进特征的高效融合. Zheng等人[18 ] 将互注意力机制和递归网络结合,扩大感受野,对可变形配准进行逐步细化.Wang等人[19 ] 利用多头邻域注意力机制显式分解不同的运动模态,再通过竞争加权模块融合多个变形子场,实现由粗到细的配准.Chen等人[20 ] 设计双流特征提取分支,结合局部窗口自注意力和局部窗口交叉注意力实现图像间特征的显式匹配. ...
Xmorpher: Full transformer for deformable medical image registration via cross attention
1
2022
... 近年来,学者们在网络中引入Transformer架构[12 ] 以建模远距离空间依赖关系.Transformer架构将输入图像分成多个patch,利用自注意力机制,通过查询(Query)、键(Key)和值(Value)矩阵计算每个patch与其他patch的相关性,使得该patch获得全局信息.Dosovitskiy等人[13 ] 受其启发于2020年提出了Vision Transformer(ViT)模型,ViT模型将输入图像划分为固定大小的patch并映射为token,对于每个token给予一个可学习的位置编码和class token,然后传入Transformer模块并通过多层感知机头(Multilayer Perceptron Head,MLP Head)得到最终结果.Chen等人[14 ] 将CNN和ViT模型结合设计了CNN-Transformer混合架构的模型Vit-V-Net,进一步提高了配准精度.在此基础上,Chen等人[15 ] 进一步提出TransMorph模型,编码器使用Swin Transformer[16 ] ,利用窗口注意力替代ViT模型的全局注意力,并且不需要额外的位置编码,降低参数量的同时提升了配准性能.后续的一些方法基于Transformer架构进行改进.Shi等人[17 ] 提出一种纯Transformer架构网络XMorpher,设计两个并行的特征提取网络分别提取固定图像和运动图像的特征,并通过交叉注意力模块建立两幅图像的对应关系,促进特征的高效融合. Zheng等人[18 ] 将互注意力机制和递归网络结合,扩大感受野,对可变形配准进行逐步细化.Wang等人[19 ] 利用多头邻域注意力机制显式分解不同的运动模态,再通过竞争加权模块融合多个变形子场,实现由粗到细的配准.Chen等人[20 ] 设计双流特征提取分支,结合局部窗口自注意力和局部窗口交叉注意力实现图像间特征的显式匹配. ...
Recursive deformable image registration network with mutual attention
1
2022
... 近年来,学者们在网络中引入Transformer架构[12 ] 以建模远距离空间依赖关系.Transformer架构将输入图像分成多个patch,利用自注意力机制,通过查询(Query)、键(Key)和值(Value)矩阵计算每个patch与其他patch的相关性,使得该patch获得全局信息.Dosovitskiy等人[13 ] 受其启发于2020年提出了Vision Transformer(ViT)模型,ViT模型将输入图像划分为固定大小的patch并映射为token,对于每个token给予一个可学习的位置编码和class token,然后传入Transformer模块并通过多层感知机头(Multilayer Perceptron Head,MLP Head)得到最终结果.Chen等人[14 ] 将CNN和ViT模型结合设计了CNN-Transformer混合架构的模型Vit-V-Net,进一步提高了配准精度.在此基础上,Chen等人[15 ] 进一步提出TransMorph模型,编码器使用Swin Transformer[16 ] ,利用窗口注意力替代ViT模型的全局注意力,并且不需要额外的位置编码,降低参数量的同时提升了配准性能.后续的一些方法基于Transformer架构进行改进.Shi等人[17 ] 提出一种纯Transformer架构网络XMorpher,设计两个并行的特征提取网络分别提取固定图像和运动图像的特征,并通过交叉注意力模块建立两幅图像的对应关系,促进特征的高效融合. Zheng等人[18 ] 将互注意力机制和递归网络结合,扩大感受野,对可变形配准进行逐步细化.Wang等人[19 ] 利用多头邻域注意力机制显式分解不同的运动模态,再通过竞争加权模块融合多个变形子场,实现由粗到细的配准.Chen等人[20 ] 设计双流特征提取分支,结合局部窗口自注意力和局部窗口交叉注意力实现图像间特征的显式匹配. ...
Modet: Learning deformable image registration via motion decomposition transformer
1
2023
... 近年来,学者们在网络中引入Transformer架构[12 ] 以建模远距离空间依赖关系.Transformer架构将输入图像分成多个patch,利用自注意力机制,通过查询(Query)、键(Key)和值(Value)矩阵计算每个patch与其他patch的相关性,使得该patch获得全局信息.Dosovitskiy等人[13 ] 受其启发于2020年提出了Vision Transformer(ViT)模型,ViT模型将输入图像划分为固定大小的patch并映射为token,对于每个token给予一个可学习的位置编码和class token,然后传入Transformer模块并通过多层感知机头(Multilayer Perceptron Head,MLP Head)得到最终结果.Chen等人[14 ] 将CNN和ViT模型结合设计了CNN-Transformer混合架构的模型Vit-V-Net,进一步提高了配准精度.在此基础上,Chen等人[15 ] 进一步提出TransMorph模型,编码器使用Swin Transformer[16 ] ,利用窗口注意力替代ViT模型的全局注意力,并且不需要额外的位置编码,降低参数量的同时提升了配准性能.后续的一些方法基于Transformer架构进行改进.Shi等人[17 ] 提出一种纯Transformer架构网络XMorpher,设计两个并行的特征提取网络分别提取固定图像和运动图像的特征,并通过交叉注意力模块建立两幅图像的对应关系,促进特征的高效融合. Zheng等人[18 ] 将互注意力机制和递归网络结合,扩大感受野,对可变形配准进行逐步细化.Wang等人[19 ] 利用多头邻域注意力机制显式分解不同的运动模态,再通过竞争加权模块融合多个变形子场,实现由粗到细的配准.Chen等人[20 ] 设计双流特征提取分支,结合局部窗口自注意力和局部窗口交叉注意力实现图像间特征的显式匹配. ...
Transmatch: A transformer-based multilevel dual-stream feature matching network for unsupervised deformable image registration
1
2023
... 近年来,学者们在网络中引入Transformer架构[12 ] 以建模远距离空间依赖关系.Transformer架构将输入图像分成多个patch,利用自注意力机制,通过查询(Query)、键(Key)和值(Value)矩阵计算每个patch与其他patch的相关性,使得该patch获得全局信息.Dosovitskiy等人[13 ] 受其启发于2020年提出了Vision Transformer(ViT)模型,ViT模型将输入图像划分为固定大小的patch并映射为token,对于每个token给予一个可学习的位置编码和class token,然后传入Transformer模块并通过多层感知机头(Multilayer Perceptron Head,MLP Head)得到最终结果.Chen等人[14 ] 将CNN和ViT模型结合设计了CNN-Transformer混合架构的模型Vit-V-Net,进一步提高了配准精度.在此基础上,Chen等人[15 ] 进一步提出TransMorph模型,编码器使用Swin Transformer[16 ] ,利用窗口注意力替代ViT模型的全局注意力,并且不需要额外的位置编码,降低参数量的同时提升了配准性能.后续的一些方法基于Transformer架构进行改进.Shi等人[17 ] 提出一种纯Transformer架构网络XMorpher,设计两个并行的特征提取网络分别提取固定图像和运动图像的特征,并通过交叉注意力模块建立两幅图像的对应关系,促进特征的高效融合. Zheng等人[18 ] 将互注意力机制和递归网络结合,扩大感受野,对可变形配准进行逐步细化.Wang等人[19 ] 利用多头邻域注意力机制显式分解不同的运动模态,再通过竞争加权模块融合多个变形子场,实现由粗到细的配准.Chen等人[20 ] 设计双流特征提取分支,结合局部窗口自注意力和局部窗口交叉注意力实现图像间特征的显式匹配. ...
A convnet for the 2020s
2
2022
... CNN通过固定卷积核获得局部感受野以提取特征空间,扩大感受野的方式为层级堆叠或者使用膨胀卷积,在参数量和计算效率方面具有优势.但受限于有限的感受野以及相同的卷积核权重,CNN方法难以建立图像间长距离的非线性空间映射,当图像存在大尺度形变或者复杂的非线性形变等情况时CNN方法的表现受限.而基于Transformer架构的方法通过自注意力机制显式建模任意特征间的相关性,让网络在全局范围内捕获空间对应关系,更适合处理大尺度形变和非线性形变,这一点弥补了CNN的不足,但通常会伴随更高的计算开销.因此,Liu等人[21 ] 根据Transformer架构的理念提出了纯卷积网络ConvNeXt,为建模远距离依赖关系,采用大卷积核替代传统的3×3卷积核,有效扩大了感受野,并采用深度可分离卷积代替标准卷积,极大降低了网络计算量.然而,医学图像尤其脑部三维MRI为高维数据,使用大核卷积对显存和算力提出极高要求,此外,ConvNeXt每层编码使用单一大小的大核卷积,易导致局部细节丢失. ...
... 结构如图2 所示,整体模块为一个深度可分离卷积[22 ] ,其采用解耦设计将通道信息和空间信息分离.对于输入的特征F input ,首先经过深度卷积对每个输入通道单独处理以提取空间维度信息.考虑到膨胀卷积能够在扩大感受野的同时不增加网络的参数和计算量,因此将深度卷积中的普通卷积替换为膨胀卷积,每层编码器使用不同的膨胀率高效捕获多尺度信息,并使用残差连接防止梯度爆炸和消失.随后,通过两个1×1×1卷积对深度卷积部分残差连接后的输出${F}^{\prime }$ [21 ] ,即优先进行深度卷积以降低计算量,接着在两个逐点卷积中将维度扩展为输入维度的2倍,达到充分融合深度卷积提取空间信息的目的,最后再将通道数压缩回原始维度,减少冗余信息,得到输出特征${F}_{\text{out}}$
Xception: Deep learning with depthwise separable convolutions
1
2017
... 结构如图2 所示,整体模块为一个深度可分离卷积[22 ] ,其采用解耦设计将通道信息和空间信息分离.对于输入的特征F input ,首先经过深度卷积对每个输入通道单独处理以提取空间维度信息.考虑到膨胀卷积能够在扩大感受野的同时不增加网络的参数和计算量,因此将深度卷积中的普通卷积替换为膨胀卷积,每层编码器使用不同的膨胀率高效捕获多尺度信息,并使用残差连接防止梯度爆炸和消失.随后,通过两个1×1×1卷积对深度卷积部分残差连接后的输出${F}^{\prime }$ [21 ] ,即优先进行深度卷积以降低计算量,接着在两个逐点卷积中将维度扩展为输入维度的2倍,达到充分融合深度卷积提取空间信息的目的,最后再将通道数压缩回原始维度,减少冗余信息,得到输出特征${F}_{\text{out}}$
Learning to upsample by learning to sample
2
2023
... 上采样模块位于网络的解码器部分,用于恢复图像分辨率并与同级经过跳跃连接的编码器特征进行融合.在基于深度学习的医学图像配准中,上采样的特征会影响后续变形场的准确性.最邻近插值、双线性插值等传统上采样方法通过简单的局部插值得到上采样后的图像,但前者会产生锯齿状伪影,后者会导致边缘模糊,均会影响配准的精度.因此,本文引入Dysample[23 ] 进行上采样,如图4 所示.与CARAFE[24 ] 、FADE[25 ] 此类基于动态核的上采样不同,Dysample利用动态采样点建模几何信息并结合PyTorch内置函数grid_sample实现上采样,具有更少计算量FLOPs和参数数量Params.具体来说,先通过双线性初始化获得初始采样位置G ,目的在于当偏移量为零时保证网络输出与双线性插值结果一致,防止初始分布不均匀导致模型训练不稳定.接着输入特征X 分别通过线性投影linear生成原始偏移${O}_{1}$ σ )对原始偏移范围进行约束,避免采样点重叠导致边界产生伪影[23 ] .然后通过PixelShuffle对其重塑得到最终的偏移量O .整个过程表示为: ...
... [23 ].然后通过PixelShuffle对其重塑得到最终的偏移量O .整个过程表示为: ...
Carafe: Content-aware reassembly of features
1
2019
... 上采样模块位于网络的解码器部分,用于恢复图像分辨率并与同级经过跳跃连接的编码器特征进行融合.在基于深度学习的医学图像配准中,上采样的特征会影响后续变形场的准确性.最邻近插值、双线性插值等传统上采样方法通过简单的局部插值得到上采样后的图像,但前者会产生锯齿状伪影,后者会导致边缘模糊,均会影响配准的精度.因此,本文引入Dysample[23 ] 进行上采样,如图4 所示.与CARAFE[24 ] 、FADE[25 ] 此类基于动态核的上采样不同,Dysample利用动态采样点建模几何信息并结合PyTorch内置函数grid_sample实现上采样,具有更少计算量FLOPs和参数数量Params.具体来说,先通过双线性初始化获得初始采样位置G ,目的在于当偏移量为零时保证网络输出与双线性插值结果一致,防止初始分布不均匀导致模型训练不稳定.接着输入特征X 分别通过线性投影linear生成原始偏移${O}_{1}$ σ )对原始偏移范围进行约束,避免采样点重叠导致边界产生伪影[23 ] .然后通过PixelShuffle对其重塑得到最终的偏移量O .整个过程表示为: ...
FADE: Fusing the assets of decoder and encoder for task-agnostic upsampling
1
2022
... 上采样模块位于网络的解码器部分,用于恢复图像分辨率并与同级经过跳跃连接的编码器特征进行融合.在基于深度学习的医学图像配准中,上采样的特征会影响后续变形场的准确性.最邻近插值、双线性插值等传统上采样方法通过简单的局部插值得到上采样后的图像,但前者会产生锯齿状伪影,后者会导致边缘模糊,均会影响配准的精度.因此,本文引入Dysample[23 ] 进行上采样,如图4 所示.与CARAFE[24 ] 、FADE[25 ] 此类基于动态核的上采样不同,Dysample利用动态采样点建模几何信息并结合PyTorch内置函数grid_sample实现上采样,具有更少计算量FLOPs和参数数量Params.具体来说,先通过双线性初始化获得初始采样位置G ,目的在于当偏移量为零时保证网络输出与双线性插值结果一致,防止初始分布不均匀导致模型训练不稳定.接着输入特征X 分别通过线性投影linear生成原始偏移${O}_{1}$ σ )对原始偏移范围进行约束,避免采样点重叠导致边界产生伪影[23 ] .然后通过PixelShuffle对其重塑得到最终的偏移量O .整个过程表示为: ...
Application of normalized cross correlation to image registration
1
2014
... 本文使用归一化互相关(Normalized cross correlation,NCC)[26 ] 作为相似性函数来优化图像间的相似性: ...
FreeSurfer
1
2012
... IXI(Information eXtraction from Images)数据集[15 ] 共包含576张T 1 加权脑部MR图像,按照7 : 1 : 2的比例划分为训练集、验证集和测试集,即分别使用403、58和115张图像进行训练、验证和测试.对于IXI数据集,本文进行了基于图谱的配准,选择Kim等人[10 ] 提供的脑图谱MRI作为运动图像.所有扫描图像均使用FreeSurfer[27 ] 进行预处理,包括颅骨剥离、重采样、仿射对齐及裁剪和归一化等步骤,所有图像尺寸裁剪为160×192×224,并使用专家标注的30个感兴趣区域(region of interest,ROI)的标签图来评估配准算法的性能. ...
Construction of a 3D probabilistic atlas of human cortical structures
1
2008
... LPBA40数据集[28 ] 包含40张T 1 W脑部MRI,划分为训练集28张,验证集4张以及测试集8张,选择S01作为固定图像进行基于图谱的配准.所有图像均通过FreeSurfer软件预处理,具体操作同IXI,最后将图像大小裁剪为160×192×160,分辨率设为1 mm×1 mm×1 mm,并勾画56个ROI评估配准性能. ...
Symmetric diffeomorphic image registration with cross-correlation: evaluating automated labeling of elderly and neurodegenerative brain
2
2008
... 本实验选择了传统配准SyN[29 ] 、NiftyReg[30 ] 以及深度学习经典算法VoxelMorph[7 ] 、CycleMorph[10 ] 、Vit-V-Net[14 ] 、TransMorph[15 ] 作为对比方法,所有模型均在配备NVIDIA RTX3090(24G)显卡的PC上使用PyTorch框架实现,使用Adam优化算法,IXI数据集训练500 epochs,LPBA40数据集训练1 000 epochs.两个数据集的学习率设置为1×10⁻⁴ ,batchsize为1.在训练过程中,对脑部MRI数据集进行数据随机翻转,实现数据增强.训练超参数的设置详见附录表A2 . ...
... 在两个不同的数据集上进行基于图谱的配准,将本文提出的模型与SyN[29 ] 、NiftyReg[30 ] 、VoxelMorph-1[7 ] 、VoxelMorph-2[7 ] 、CycleMorph[10 ] 、Vit-V-Net[14 ] 及TransMorph[15 ] 比较并进行定量和定性分析.其中,SyN和NiftyReg为基于迭代优化的经典传统配准算法,VoxelMorph-1、VoxelMorph-2以及CycleMorph是基于CNN的深度学习配准方法,Vit-V-Net和TransMorph是基于Transformer的深度学习配准方法.表1 和表2 是不同配准模型在IXI数据集和LPBA40数据集上的定量结果,粗体表示最优结果. ...
Fast free-form deformation using graphics processing units
2
2010
... 本实验选择了传统配准SyN[29 ] 、NiftyReg[30 ] 以及深度学习经典算法VoxelMorph[7 ] 、CycleMorph[10 ] 、Vit-V-Net[14 ] 、TransMorph[15 ] 作为对比方法,所有模型均在配备NVIDIA RTX3090(24G)显卡的PC上使用PyTorch框架实现,使用Adam优化算法,IXI数据集训练500 epochs,LPBA40数据集训练1 000 epochs.两个数据集的学习率设置为1×10⁻⁴ ,batchsize为1.在训练过程中,对脑部MRI数据集进行数据随机翻转,实现数据增强.训练超参数的设置详见附录表A2 . ...
... 在两个不同的数据集上进行基于图谱的配准,将本文提出的模型与SyN[29 ] 、NiftyReg[30 ] 、VoxelMorph-1[7 ] 、VoxelMorph-2[7 ] 、CycleMorph[10 ] 、Vit-V-Net[14 ] 及TransMorph[15 ] 比较并进行定量和定性分析.其中,SyN和NiftyReg为基于迭代优化的经典传统配准算法,VoxelMorph-1、VoxelMorph-2以及CycleMorph是基于CNN的深度学习配准方法,Vit-V-Net和TransMorph是基于Transformer的深度学习配准方法.表1 和表2 是不同配准模型在IXI数据集和LPBA40数据集上的定量结果,粗体表示最优结果. ...
Measures of the amount of ecologic association between species
1
1945
... 本文采用戴斯相似性系数(Dice similarity coefficient,DSC)[31 ] 、95%的豪斯多夫距离(95% Hausdorff Distance,HD95)[32 ] 、非正雅可比行列式的百分比(%$\left|{J}_{\phi }\right|$
An efficient algorithm for calculating the exact Hausdorff distance
1
2015
... 本文采用戴斯相似性系数(Dice similarity coefficient,DSC)[31 ] 、95%的豪斯多夫距离(95% Hausdorff Distance,HD95)[32 ] 、非正雅可比行列式的百分比(%$\left|{J}_{\phi }\right|$
Encoder-decoder with atrous separable convolution for semantic image segmentation
1
2018
... MDRC目的在于提取多尺度特征,为验证其优越性,将MDRC与ASPP[33 ] 对比.ASPP使用多个并行膨胀卷积捕获多尺度的上下文信息,MDRC则通过串行、逐层递增膨胀率的方式构建多尺度感受野.表4 展示了两者的对比结果.根据表4 的各项指标可以发现,MDRC和ASPP的DSC值相同,但ASPP的HD95和非正雅可比行列式百分比明显比MDRC差,其HD95为2.124 mm,非正雅可比行列式百分比的值达到1.506%,说明存在明显折叠区域.本文设计的MDRC在参数量、计算量、内存及时间等方面均优于ASPP. 根据ASPP的结构可以推测,其使用并行分支,每个分支具有不同的膨胀率,这会导致膨胀率较大的卷积核提取到的特征更稀疏且不连续,使得经解码器上采样后的变形场不够平滑.其并行分支在拼接前需保存多个分支的临时特征图,导致内存占用高、耗时长.同时,多分支的普通卷积比深度可分离卷积具有更多的计算参数,因此ASPP的参数量和计算量的值比MDRC高.而MDRC采用串行、渐进式的方式进行多尺度建模,使每一层都在上一层提取的特征的基础上进一步扩大范围,更利于捕捉细微的形变,降低计算负担的同时保证配准精度. ...
CBAM: Convolutional block attention module
1
2018
... 本文所设计的注意力模块CSDA旨在高效建模通道和空间双维度上的特征,增强网络对关键解剖区域的感知能力.为了验证CSDA的优越性,将CSDA替换为CBAM[34 ] 和SE[35 ] 注意力模块进行对比分析.结果如表4 所示,本文的CSDA模块在参数量和计算量相近的情况下,DSC、HD95和非正雅可比行列式百分比的值等多个指标上均取得了最佳结果.DSC较CBAM、SE提升了0.81%和0.54%,HD95减小了2.90%和2.05%.SE注意力机制将空间维度进行压缩后使用全连接层学习通道间的相关性,模型会更加关注通道信息而忽略空间信息;CBAM则在通道注意力的基础上进一步引入空间注意力,同时关注通道和空间信息,但空间注意力对所有的通道使用统一的空间权重,容易忽略不同通道间的差异.而CSDA在通道注意力部分使用一维卷积实现跨通道特征提取,避免全连接层带来的计算开销,空间注意力部分分成多组独立的空间注意力,对不同特征分配不同权重,更有效地捕捉关键特征,提升配准精度.值得注意的是,CBAM和本文设计的CSDA同为通道-空间双维度注意力模块,两者在参数量、计算量和内存占用方面的结果相近,但CSDA的配准时间略优于CBAM,实现了更高的计算效率,展现了本文模块的有效性. ...
Squeeze-and-excitation networks
1
2018
... 本文所设计的注意力模块CSDA旨在高效建模通道和空间双维度上的特征,增强网络对关键解剖区域的感知能力.为了验证CSDA的优越性,将CSDA替换为CBAM[34 ] 和SE[35 ] 注意力模块进行对比分析.结果如表4 所示,本文的CSDA模块在参数量和计算量相近的情况下,DSC、HD95和非正雅可比行列式百分比的值等多个指标上均取得了最佳结果.DSC较CBAM、SE提升了0.81%和0.54%,HD95减小了2.90%和2.05%.SE注意力机制将空间维度进行压缩后使用全连接层学习通道间的相关性,模型会更加关注通道信息而忽略空间信息;CBAM则在通道注意力的基础上进一步引入空间注意力,同时关注通道和空间信息,但空间注意力对所有的通道使用统一的空间权重,容易忽略不同通道间的差异.而CSDA在通道注意力部分使用一维卷积实现跨通道特征提取,避免全连接层带来的计算开销,空间注意力部分分成多组独立的空间注意力,对不同特征分配不同权重,更有效地捕捉关键特征,提升配准精度.值得注意的是,CBAM和本文设计的CSDA同为通道-空间双维度注意力模块,两者在参数量、计算量和内存占用方面的结果相近,但CSDA的配准时间略优于CBAM,实现了更高的计算效率,展现了本文模块的有效性. ...